
5000 tokens 变 50 tokens——本地 LLM 画流程图,有人想到了一个取巧的办法。
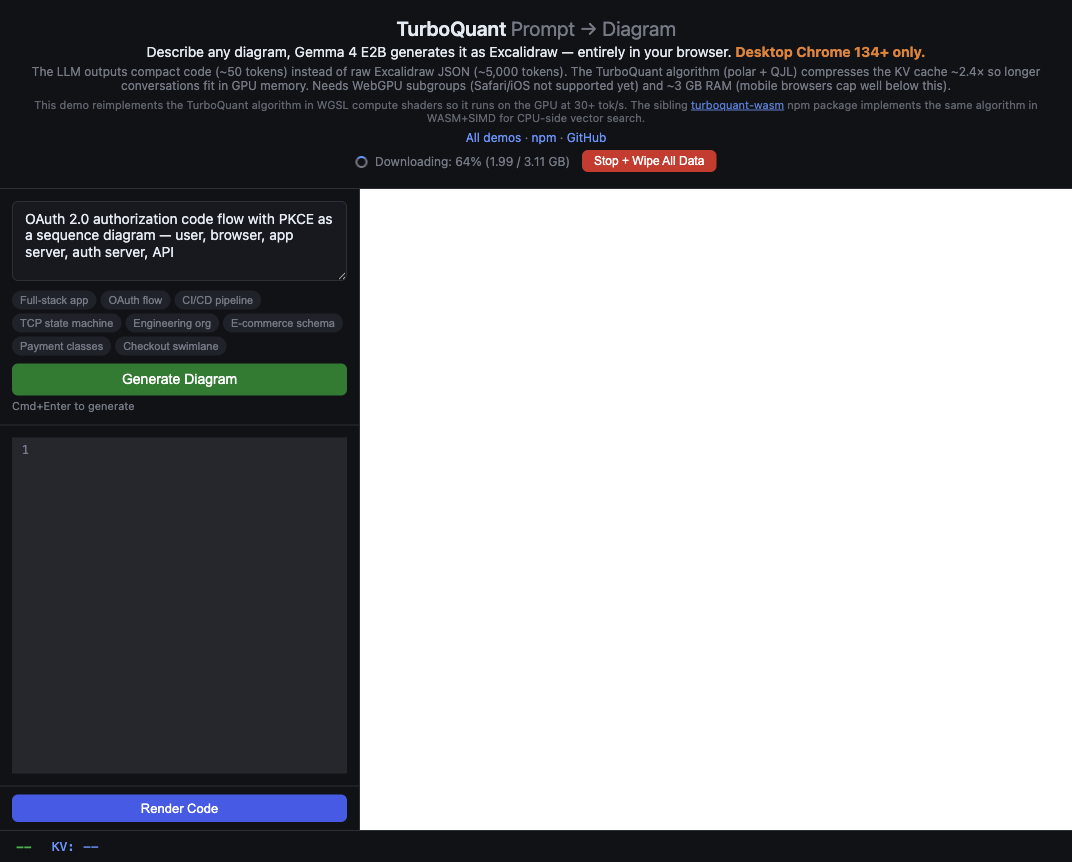
Gemma 4 E2B 跑在浏览器里,完全离线,没有 API key,不联网。输入一句「画个 OAuth flow」,几秒钟出一张能用的 Excalidraw 图。作者是 teamchong,demo 放在 turboquant-wasm 这个开源项目里。
一般让 LLM 吐流程图,输出的是 JSON——节点、边、坐标、样式,一张中等复杂度的图动辄 5000 tokens 起跳,本地小模型基本写不完就跑偏了。这个 demo 换了思路:让模型直接输出 Excalidraw 的代码格式,压到了 50 tokens 左右。差了 100 倍。
另一个技术细节是 KV cache。浏览器显存吃紧,作者写了一套 WGSL compute shader 把 KV cache 压了 2.4 倍,整体能跑到 30+ tok/s。不算惊艳,但对本地模型来说够用。
门槛:Chrome 134+,桌面端,大概要 3GB 内存。Safari、iOS 还不行。想试的人打开 teamchong.github.io/turboquant-wasm/draw.html 就能玩,整个流程 30 秒内跑完。
本地 LLM 在浏览器里能用到这个程度,技术活主要在工程层,不是模型层。
#AI #本地LLM #Gemma #WebGPU #AI工具
原始来源:https://teamchong.github.io/turboquant-wasm/draw.html
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS