
把 15 款 AI coding agent 摆在桌上一个月,写同一个仓库、修同一批 bug——最后只有 3 个留在每天的工作流里。
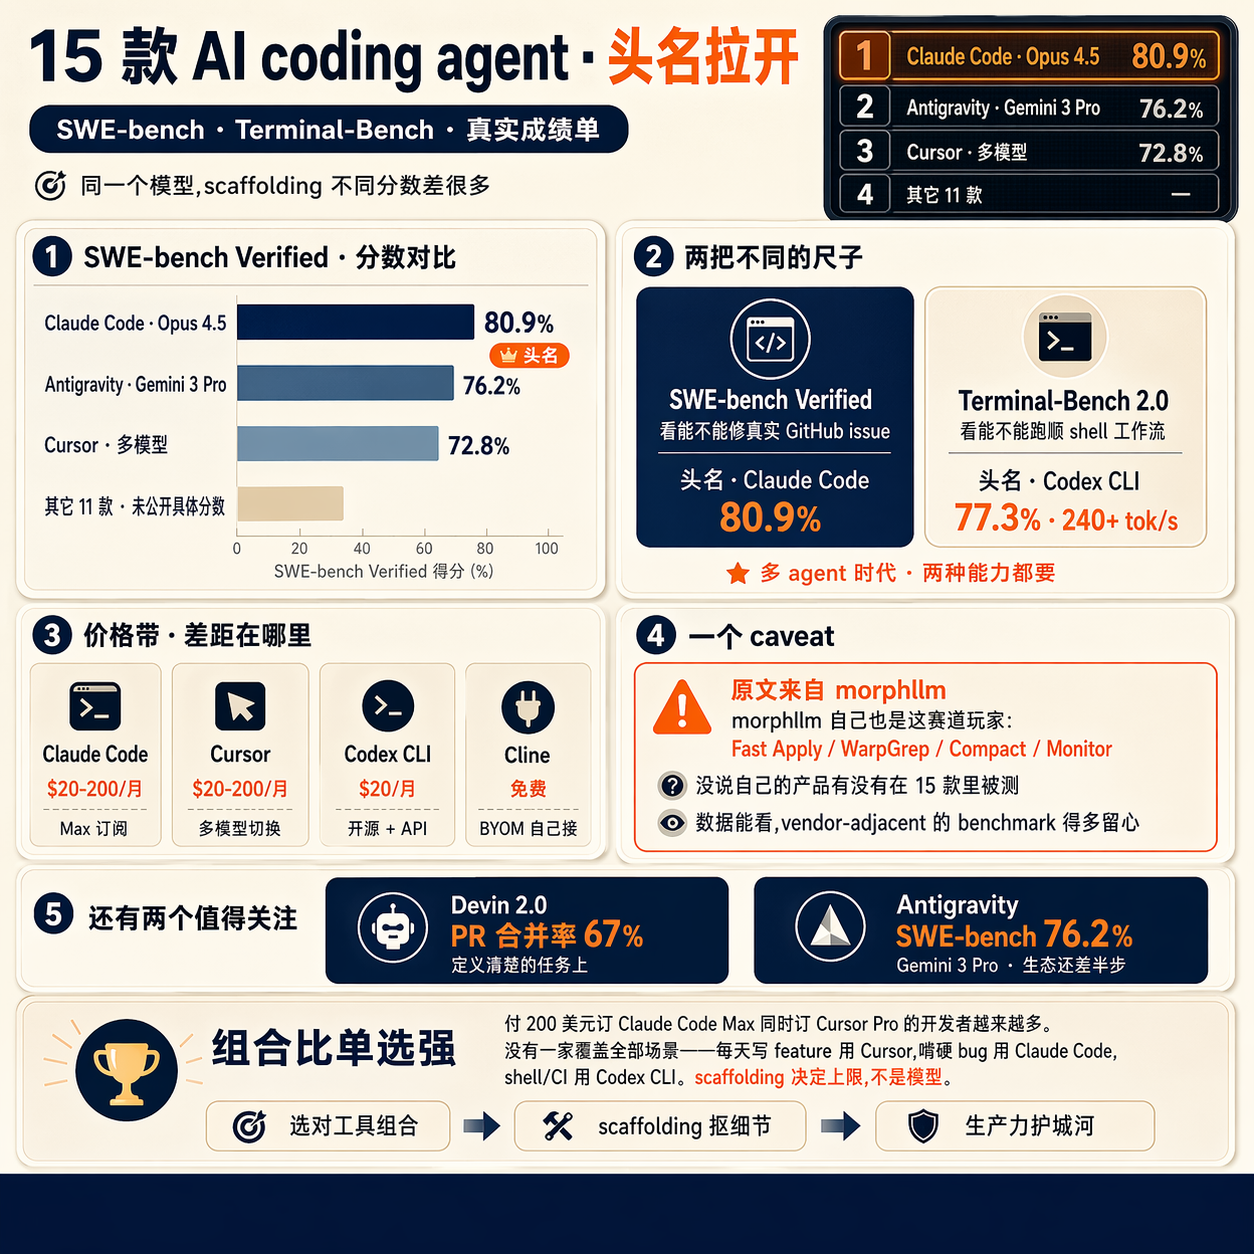
这是 morphllm 团队最近放出来的一份测评。先看数字——
SWE-bench Verified 分数:
Claude Code(Opus 4.5):80.9%
Antigravity(Gemini 3 Pro):76.2%
Cursor(多模型):72.8%
Terminal-Bench 2.0:
Codex CLI(GPT-5.3):77.3%,推理速度 240+ tokens/秒
Devin 2.0 没跑 SWE-bench,但公开了一个更硬的数据:在定义清晰的任务上 PR 合并率 67%。
作者挑出的「真的改变交付方式」的三家是:Claude Code、Codex CLI、Cursor。其它 12 款包括 Windsurf、Cline、GitHub Copilot、Aider、OpenCode、Kilo Code、Jules、Amazon Q 等,没给具体分数,只给了一句话定位。
读之前得知道一件事——morphllm 自己是这个赛道的玩家。它家的产品线 Fast Apply、WarpGrep、Compact、Monitor 都是围绕 coding agent 的基础设施层。这篇测评文章没明说自己的产品有没有被测,也没明确标注 COI。数据能看,vendor-adjacent benchmark 得多留个心眼。
即使带着那层警觉看,几个观察还是能站住脚。
第一,同样一个模型,scaffolding 不同分数差很多。Cursor 用的是「多模型混合」,72.8% 也算体面;Claude Code 咬着 Opus 4.5 一路训到 80.9%,差距不在模型,在任务编排和工具循环怎么写。这跟昨晚那条 Karpathy CLAUDE.md 讲的是同一件事——提示边界、成功标准、手术刀式修改,都是 scaffolding 层面的功夫。
第二,价格带分化严重。Claude Code 和 Cursor 都是 20-200 美元/月的套餐,Codex CLI 走 20 美元 API 路线,Cline 免费但要 BYOM(自己接模型)。选工具的时候,得权衡的是 8 分的差距值不值得每月多付 180 美元。对每天写 feature、跑很多小任务的人,Cursor 的 72.8% 加上它的交互流畅度可能就够了;对啃硬 bug 和大重构占主业的人,那 8 分是生产力的护城河。
第三,Terminal-Bench vs SWE-bench 衡量的是不同维度。SWE-bench 看能不能修真实 GitHub issue,Terminal-Bench 看能不能把 shell 工作流跑顺。Claude Code 赢在前一项,Codex CLI 赢在后一项。多 agent 产品的时代,两种能力都要。
真正的用户路径大概是这样:每天写 feature 用 Cursor 体验最顺;重构大工程、啃硬 bug 用 Claude Code;shell/CI/运维流水线用 Codex CLI。三家都留在工具链里,不是二选一。付 200 美元订阅 Claude Code Max 同时订阅 Cursor Pro 的开发者越来越多——谁家都不完整,但组合起来比过去任何单一 IDE 都强。
至于 Devin 和 Antigravity——Devin 的 67% PR 合并率是个真实且高的数,只是定义在「任务清楚的前提下」,这句限定把数字拉回地面;Antigravity 76.2% 的 SWE-bench 值得关注,Gemini 3 Pro 的底层能力不弱,只是产品化和生态比头部三家还差半步。
转给还在纠结「选 Claude Code 还是 Cursor」的同事——答案是两个都订,组合比单选强。
https://www.morphllm.com/ai-coding-agent
关注 @svtransit1 · 每天都有有用的 AI 资讯
#ClaudeCode #Cursor #Codex #AI #编程
原始来源:https://www.morphllm.com/ai-coding-agent
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS