
一份 CLAUDE.md 模板,GitHub 上 79000 ⭐,本周 Trending 榜单常客。
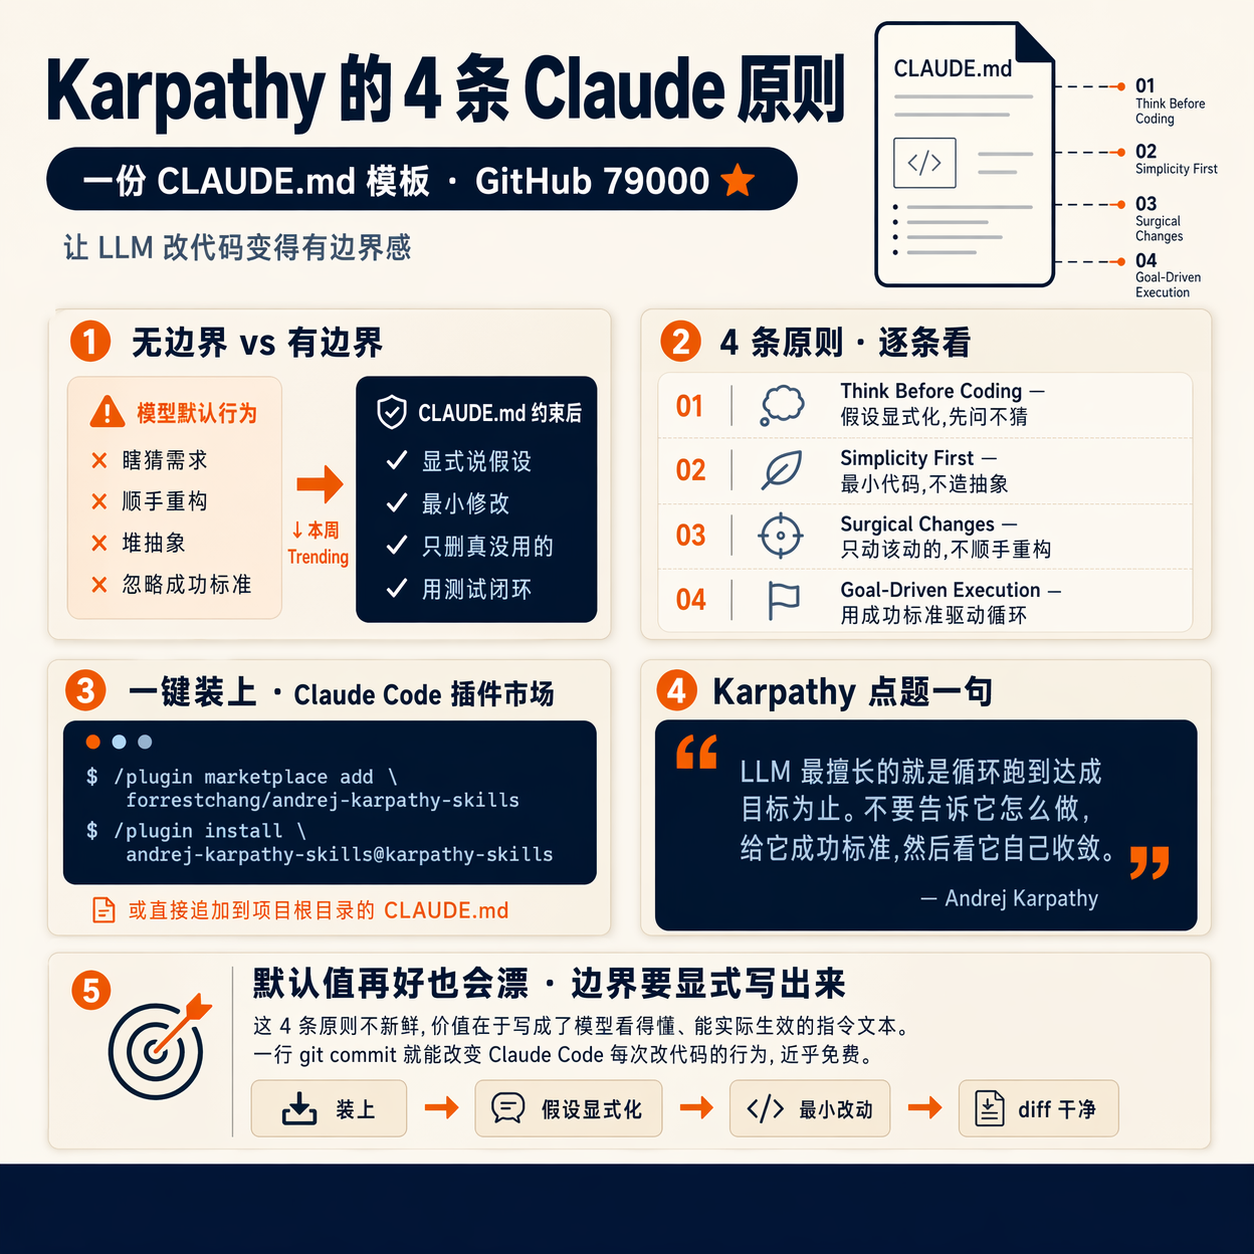
作者 Forrest Chang 把 Andrej Karpathy 平时吐槽 LLM 的几个毛病——瞎猜需求、顺手重构、抽象层堆得像汉堡——提炼成 4 条原则,写进一个 Claude Code 和 Cursor 都能直接用的 CLAUDE.md。
- Think Before Coding · 先想清楚再动手
让模型显式说出它的假设,给出多种理解,不确定就问一句,而不是猜了就往下写。Karpathy 原话大意:「模型最糟糕的地方是替你猜错了,还一路按这个猜测跑下去。」这一条直接针对那种现象。
- Simplicity First · 别想太多
只写解决当前问题必需的代码。不要顺手加 feature、不要造抽象、不要塞「未来可能用得上」的可配置参数。最小化,然后停下来。
- Surgical Changes · 手术刀式修改
改已有代码时,只动真正该动的地方。沿用现有风格、不重构没坏的东西、只删掉你的改动让它变得没用的 import 和变量。
- Goal-Driven Execution · 用成功标准开路
把「修这个 bug」变成「写一个能复现这个 bug 的测试,跑通它」。作者引用 Karpathy 一句话特别点题:
「LLM 最擅长的事就是循环跑到达成目标为止。不要告诉它怎么做,给它成功标准,然后看它自己收敛。」
装起来很简单。Claude Code 插件市场一行:
/plugin marketplace add forrestchang/andrej-karpathy-skills
/plugin install andrej-karpathy-skills@karpathy-skills
已有项目直接把这份 CLAUDE.md 追加到项目根目录的 CLAUDE.md 里就行。
这 4 条听上去都没什么新意——没人会反对「先想清楚再写」。但这份东西真正值钱的地方,是把它们写成了模型看得懂、能实际生效的指令文本。像给新员工发员工手册,不是贴在墙上那种,是真的会被翻的那种。
这跟今天早上那条「Claude 默认比 GPT 克制」的 benchmark 刚好接得上:默认值再好也会漂,把边界显式写出来才稳。这份 CLAUDE.md 大致就是那个「显式写出来」的底稿。一行 git add + commit 能改变 Claude Code 每次改代码的行为,成本低得近乎免费。
https://github.com/forrestchang/andrej-karpathy-skills
关注 @svtransit1 · 每天都有有用的 AI 资讯
#ClaudeCode #Karpathy #CLAUDEmd #AI #编程
原始来源:https://github.com/forrestchang/andrej-karpathy-skills
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS