
同一个 bug 交给 Claude 和 GPT 修,GPT 多改了 6 倍的代码。
多出来的那部分不是 bug 的修复,是模型自己「顺手」改的——它觉得你应该想要的。
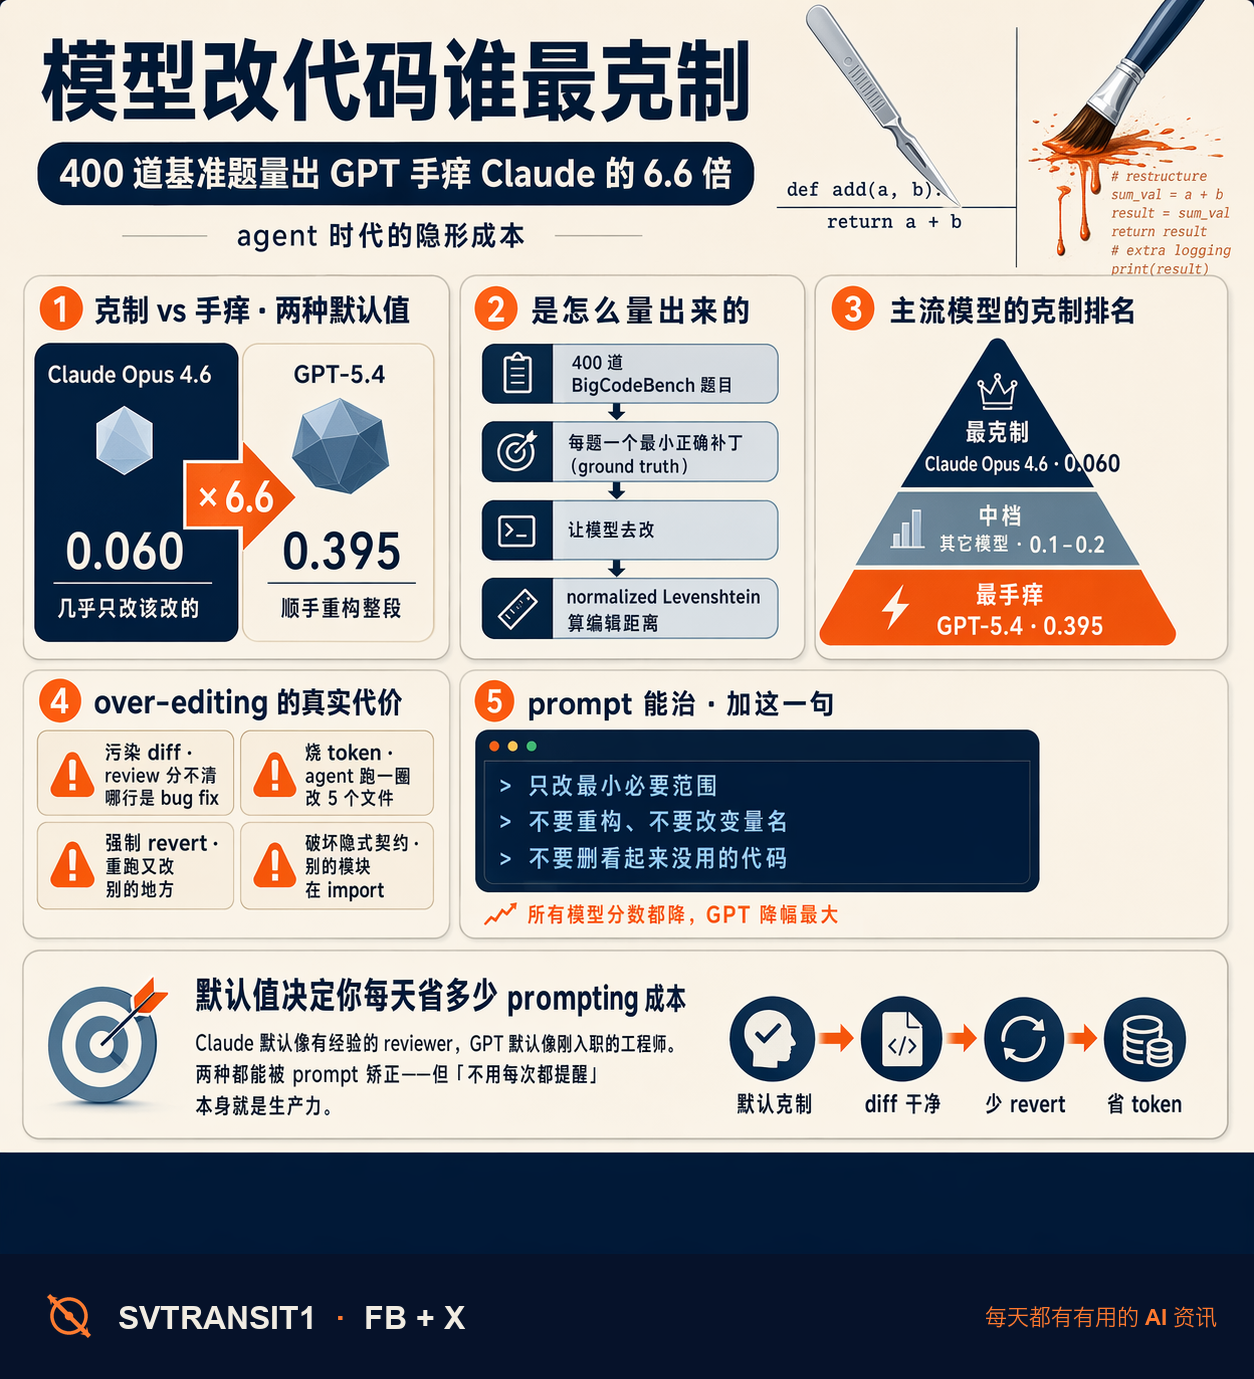
有人把这件事量化了。作者 nrehiew 跑了 BigCodeBench 的 400 道题,每题都有一个「最小正确补丁」作为参考答案。然后让几个主流模型去改,再用 normalized Levenshtein distance 算它们改的量和参考答案差了多少。数字越小越克制,越大越「手痒」。
Claude Opus 4.6:0.060
GPT-5.4:0.395
两个数字相差将近 6.6 倍。GPT-5.4 是这一轮里最喜欢「顺手重构」的模型,Claude Opus 4.6 是最克制的。中间档的几个模型分数都在 0.1~0.2 之间。
0.060 是什么概念——大概相当于「改了参考答案里该改的那几个字符,别的基本没碰」。0.395 就是「该改的改了,顺便还改了差不多同样多的别的地方」。
在 agent 跑代码的时代,over-editing 的代价已经不只是「多写几行」。你让它修一个 auth bug,它顺手把 logging 格式改了、把变量名统一了、把一段它觉得没用的 helper 删了。人工 review 的时候根本分不清哪些是修 bug、哪些是它自己加戏,最后很多人只能整段 revert,让模型重跑一次——但这一次它可能又改了别的地方。
更麻烦的是 prod 代码不像 BigCodeBench 那么干净。那些「看起来可以写得更漂亮」的地方经常藏着隐式契约:别的模块正在 import、测试里断言着某个字段名、同事上周才加的绕坑 hack。模型看不到这些上下文,它只看到局部可以优化。
作者也发现一个可操作的结论:这个毛病靠 prompt 能治。在请求里明确加一句「只改最小必要范围,不要重构、不要改变量名、不要删看起来没用的代码」——所有模型的 Levenshtein 分数都明显下降,GPT 降幅最大。换句话说,问题出在模型的默认行为上,能力都在、只是没对齐到「克制」这个方向。
对日常用法的启发很简单:主力用 GPT 的,在 system prompt 里把「最小修改」作为硬约束写进去,不要靠每次 user prompt 重复。主力用 Claude 的,review 时还是要看 diff——克制不等于不越界,只是概率低一些。如果跑 agent workflow、让模型连续改 5~10 个文件,那”默认克制”累积下来能省掉大量 revert 和 re-run。
Claude 的默认值更接近一个有经验的 reviewer 给你的第一版改动;GPT 的默认值更像刚入职的工程师想多留点 footprint。两种都可以被 prompt 矫正,但「不用每次都提醒」本身就是生产力。
你用的主力模型默认是哪一种?转给那个还在为「模型又把我代码改花了」吐槽的同事。
https://nrehiew.github.io/blog/minimal_editing/
关注 @svtransit1 · 每天都有有用的 AI 资讯
#Claude #GPT #AIagent #Coding #AI工具
原始来源:https://nrehiew.github.io/blog/minimal_editing/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS