
Google 第 8 代 TPU 发布了两颗芯片——一颗负责训练,一颗负责推理。听上去像常规的换代,但仔细看 spec sheet 会发现 Google 第一次把「agent 时代」明明白白写进了硬件设计目标。
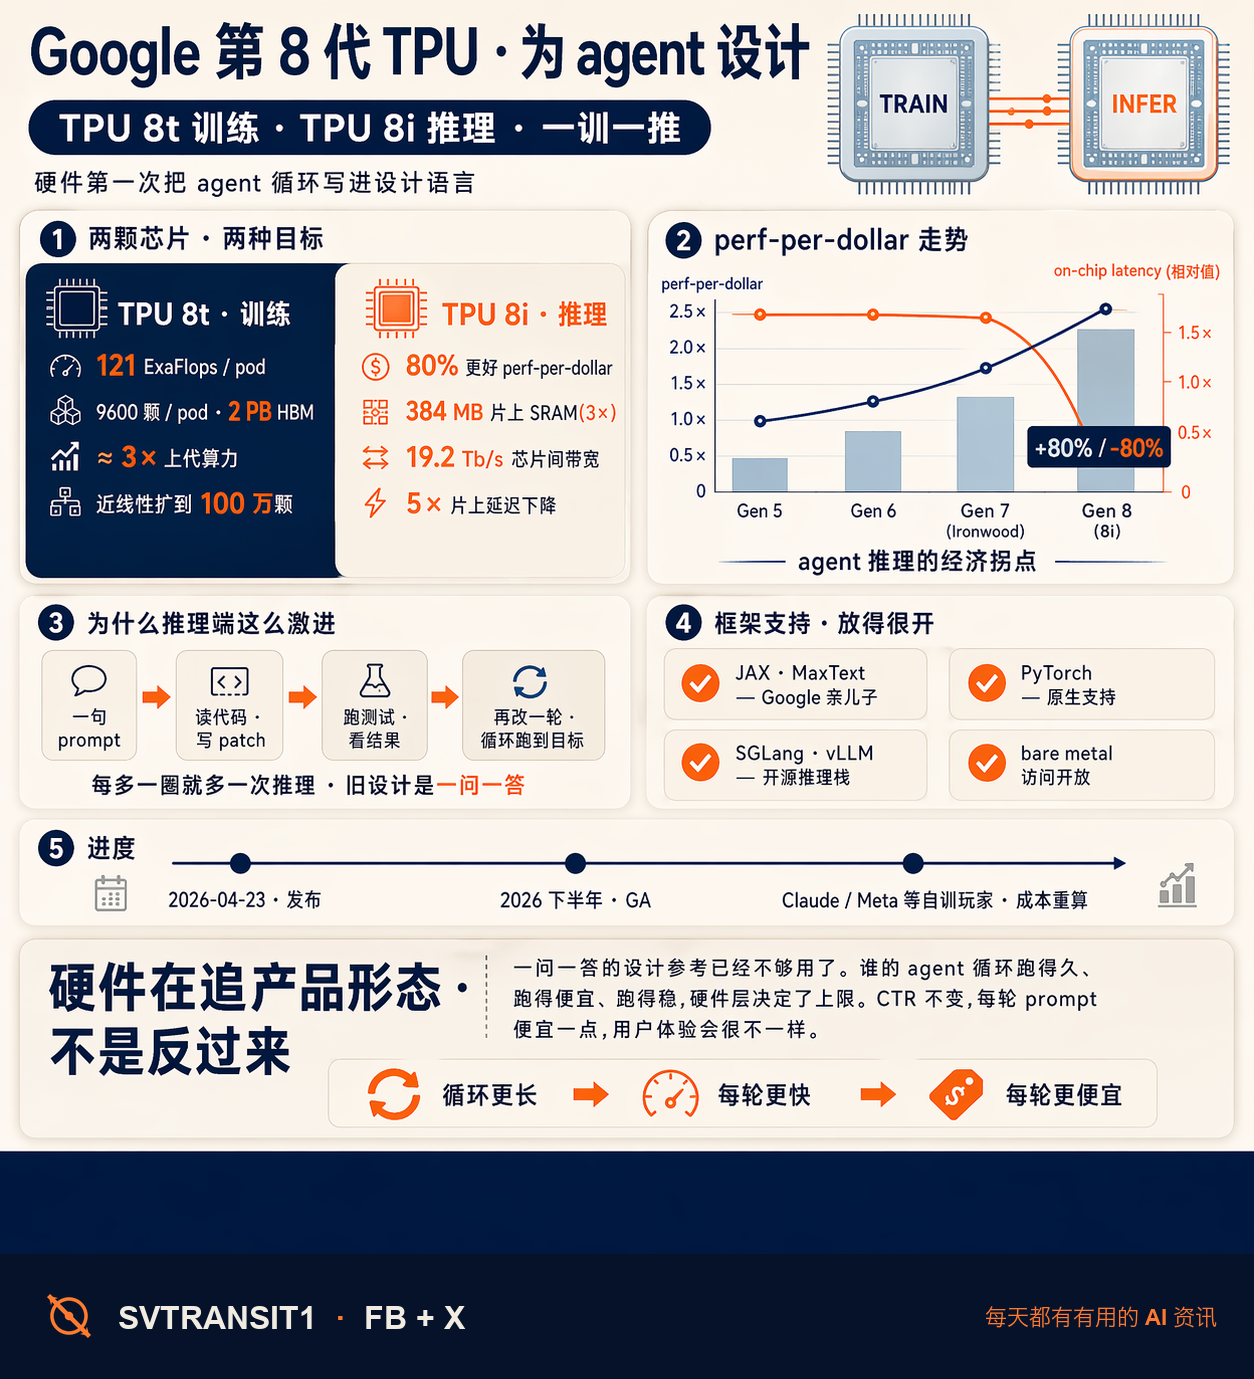
两颗的名字很朴素:TPU 8t 给训练,TPU 8i 给推理。
训练那颗 TPU 8t 单 superpod 峰值 121 ExaFlops,里面塞了 9600 颗芯片,共享 2 PB 的 high bandwidth memory,芯片间带宽直接比上代翻一倍。Google 的说法是单 pod 算力约为上代的 3 倍,架构上能近乎线性地扩到 100 万颗。目标很清楚:是为了训练那种需要动 100 万卡规模的下一代大模型。
真正值得看的是推理这颗 TPU 8i。80% 更好的 perf-per-dollar,同样的预算能服务接近 2 倍的客户请求。on-chip SRAM 提到 384 MB(上代的 3 倍),芯片间网络带宽 19.2 Tb/s,通过 Collectives Acceleration Engine 把 on-chip latency 压低到上代的 1/5。
为什么推理端要这么激进——这正是「agent 时代」的硬件注脚。
过去推理硬件的设计参考场景是「一句 prompt 进来,一段回答出去」,追求单次吞吐。现在的场景完全不同:一个 Claude Code 任务要模型读代码、写 patch、跑测试、看结果、再改一轮,循环跑到达成目标。Google 博客里的原话很直白——模型需要「通过问题推理、执行多步工作流、从自己的行动中学习」,在「连续循环」里工作。TPU 8i 被明确说是为了「很多专业化 agent 协作的复杂流程」设计。
落到工程上,这意味着两件事。一是 agent loop 里那种 token-by-token 的小 batch 推理会远比一次性 batch 更多——每多一次循环就多一次推理。二是多 agent 互相传 context 的 latency 成了新瓶颈,CAE 砍 5× 延迟直接踩在这个点上。硬件设计思路从「一次跑快一点」变成「循环跑稳一点」,两种目标对芯片的取舍是真不一样。
框架支持这次也放得很开:JAX、MaxText 是 Google 亲儿子,但也原生支持 PyTorch、SGLang、vLLM,甚至开放 bare metal 访问。意思很明显——不强迫你进 Google 的生态,想用 vLLM 部开源模型也可以直接跑。
GA 时间是 2026 下半年。对 Anthropic、Meta、各家自训模型的玩家来说,这一代 TPU 给推理成本结构会带来一轮重算——多 agent 场景里,谁家算力便宜且 latency 低,谁家就能让自己的 agent 产品跑得更久、链条更长。
对一般开发者最直接的影响在账单上。根据此前公开的合作协议,Anthropic 的 Claude 一部分推理就跑在 Google Cloud 的 TPU 上,所以 TPU 8i 的成本曲线迟早会悄悄传导到 Claude API 定价和 Claude Code 的单任务成本上。按 80% perf-per-dollar 改善折算,同样一段 agent 任务底层算力账单的下降幅度会相当可观——让那种一跑半小时、循环 30 轮的长链路 agent 真的变得经济可行。
把时间拉长一点看,过去 18 个月 agent 从 demo 跑到生产,软件侧的成本下降基本靠模型蒸馏和量化在撑。硬件这一代开始正面参战,意味着 agent 产品的竞争维度要变——不再只是「谁家模型更聪明」,而是「谁家基础设施让长循环跑得又稳又便宜」。Google 把这条赛道提前一步占位了。
Nvidia 那边不会坐视不理。B100、R100 路线图上也有针对小 batch 推理和 agent 工作流的优化,只是还没这么明确把「agent」写进市场语言。AWS Trainium 3 也在 roadmap 里,同样押在推理侧。硬件层面的这场竞争,最终决定了下一代 AI 产品能不能跑 10 分钟不崩、循环 30 轮不爆账单——以及创业团队在跑自己 agent 产品时,用哪家云的成本曲线会更陡地往下走。
硬件这次在追产品形态跑,也是第一次真正把「agent 循环」写成了设计语言,而不是「chatbot 回答」。
https://blog.google/innovation-and-ai/infrastructure-and-cloud/google-cloud/eighth-generation-tpu-agentic-era/
关注 @svtransit1 · 每天都有有用的 AI 资讯
#AI #TPU #Google #DeepMind #AIagent
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS