
同一份 coding-agent 的活,Dirac 跑出 65.2%,Junie CLI 64.3%,Google 自家 baseline 47.6%。这是 TerminalBench-2 上刚出的成绩。一个开源的项目,把闭源选手压在身下了。
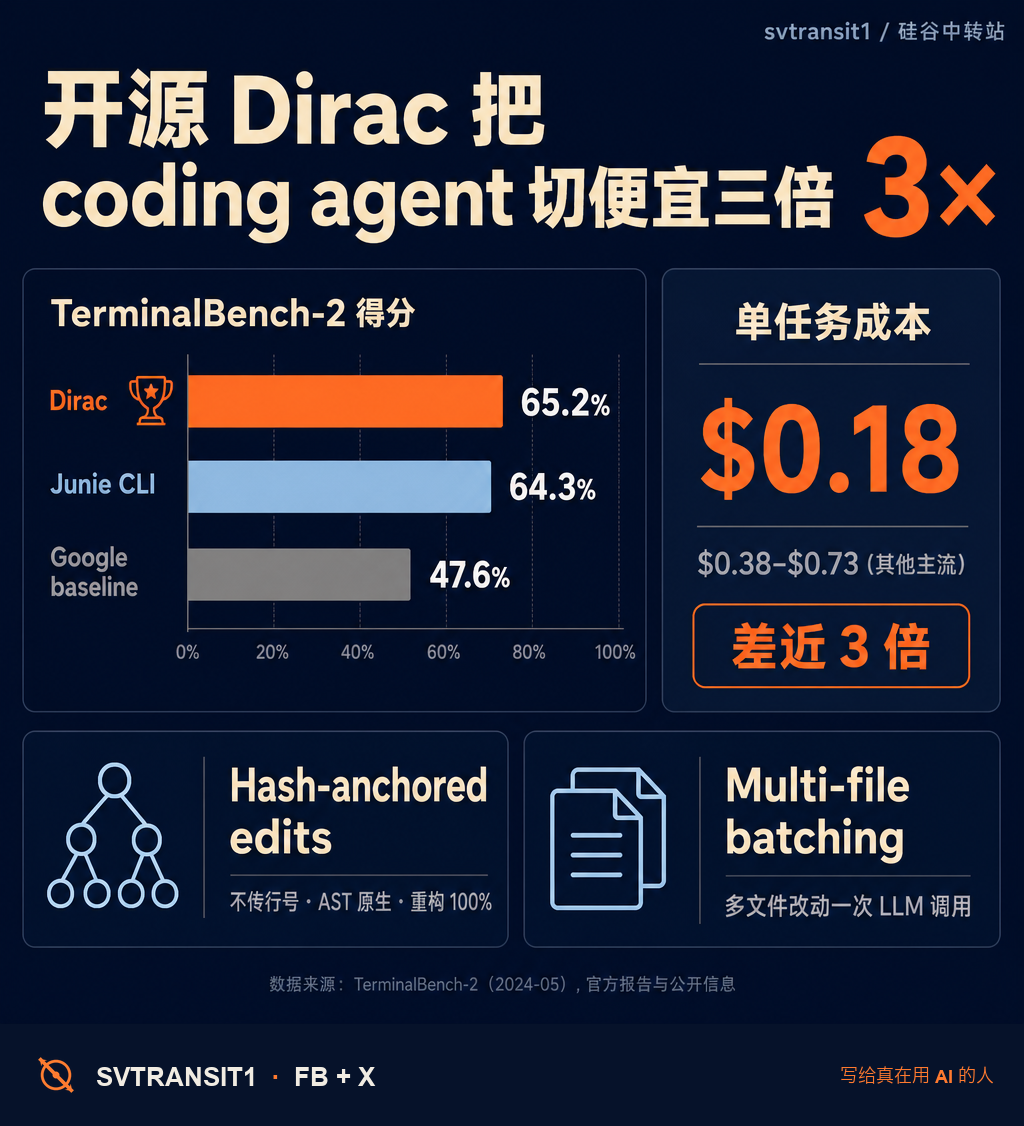
更扎眼的是成本。同一份活,Dirac 单任务 0.18 美元。横向对比,主流 coding agent 单任务在 0.38 到 0.73 美元之间。差不多三倍的差距。
把这两组数字摆在一起看,问题就清楚了——大家底层都接 Claude / GPT-5 / Gemini,模型一样贵。Dirac 的便宜不是来自更便宜的 token,是来自工程层面少算了几次。
⠀
具体看三个轴:
精度轴:常规 agent 改文件靠行号定位,模型一改,行号错位,要么翻车要么重试。Dirac 不传行号——每个改动锚定文件内容的 hash,模型直接在 AST 层面操作。重构任务的 8 个测试,Dirac 一次性全部通过,准确率 100%。
调用轴:传统 agent 改三个文件来回模型三次,每次都重新读上下文。Dirac 把多个文件的改动打包,一次 LLM 调用解决。延迟和 token 双降。
部署轴:开源 + 单二进制安装,本地跑、看得到代码。比起 Cursor 的订阅锁、Claude Code 的网关绑定,Dirac 给出的是一条可审计、可替换、可 fork 的路径。生产环境敢上的人多了一道门。
⠀
把这三件事拼起来:hash 减少重试,batching 减少调用次数,开源拿掉绑定锁。性能不是堆模型堆出来的,是把”改一次代码”这个动作切得更省。
谁该选哪个:小项目、单文件改动、依赖 Claude Code 的人继续用 Claude Code,无需折腾。中大型 codebase、token 账单已经在劝退、想要工程层可见性的人,Dirac 的思路值得搬一份过去自己手写一遍——先生成 hash,再让模型改,最后 verify。
发布 15 小时拿了 312 个 HN 赞。开源,代码可读,benchmark 数据全公开。这赛道——Claude Code、Cursor、Junie、Aider——已经卷到不能再卷,Dirac 用一组干净的数字切了进来。
值得一同看清的:65.2% 不是终局。复杂多语言项目、跨进程调试、UI 改动这类 benchmark 不擅长测量的活,这些数据没回答。Dirac 的真正考验是被几百个开发者塞进生产 codebase 之后,issue tracker 长什么样。三个月之后再回来看这个分数。
⠀
转给那个还在用 Claude Code 直接改大 codebase 的同事。
关注 @svtransit1 · 写给真在用 AI 的人
原文链接放在第一条评论 ↓
#AI #ClaudeCode #CodingAgent #开源 #TerminalBench
原始来源:https://github.com/dirac-run/dirac
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS