
如果你在用 Claude Code 但被价格劝退,这个项目值得花 10 分钟看一看。GitHub 一夜之间窜到 17,600 stars,+1,700 stars/24h,叫 free-claude-code。它做的事很简单:在 Claude Code 跟 Anthropic 之间插一层 proxy,把请求改写成 OpenAI 协议,然后丢给 NVIDIA NIM、DeepSeek、Llama、或者本地 Ollama。
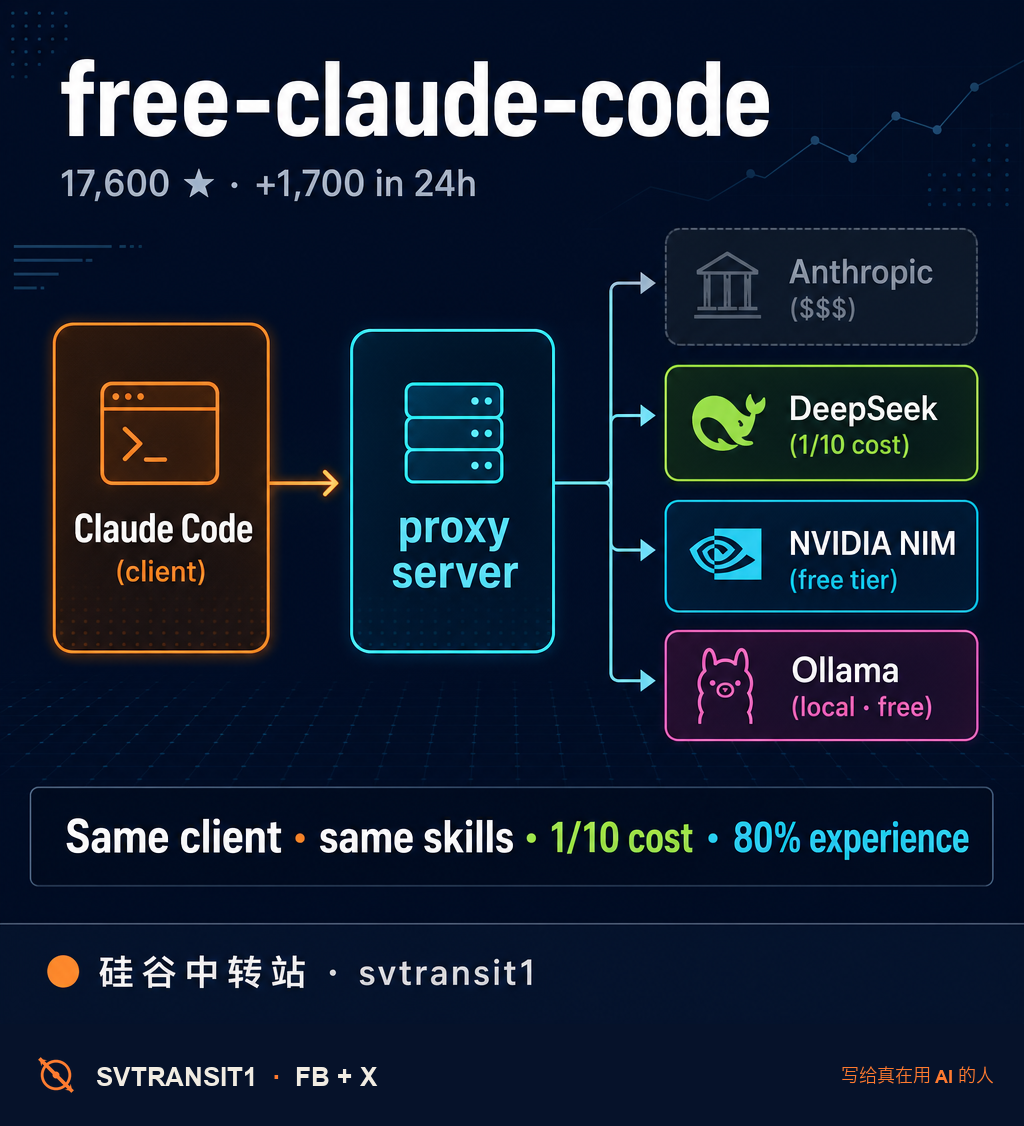
意义在于:你可以保留 Claude Code 那一套你已经熟的工作流 — slash commands, skills, /compact, agent — 但是后端不再是 $20/月起的 Anthropic API。
跟原版 Claude Code 的几条对比:
成本:原版按 Anthropic token 计费,Sonnet 4.6 input $3/M、output $15/M,一天写代码烧 $5-10 是正常的,公司账号月支出 $200-500 不奇怪。free-claude-code 用 DeepSeek 大概是原价的 1/10,一个月预算可以从 $200 压到 $20-30;用 NVIDIA NIM 免费层有限额但够个人项目跑;Ollama 跑 70B 本地完全免费,代价是一台够强的 Mac 或显卡机 — M1 Max 32GB 跑 30B 量化模型够用,70B 要 64GB 才舒服。
速度:原版直连 Anthropic 服务器,延迟稳定。proxy 多了一跳,加上后端模型不同,延迟从快到慢:NVIDIA NIM ≈ Anthropic、DeepSeek 慢一点、Ollama 看你机器、Llama via OpenRouter 看路由。Tool calling 的 round-trip 影响最明显 — agent 跑长链条任务这一档差距会被放大。具体一点:一个普通 “读 5 个文件、改 2 个 bug、跑测试” 的 agent task 在 Anthropic 上 30 秒搞定,DeepSeek 后端可能要 50-60 秒,Ollama 70B 在 M1 Max 上要 1-2 分钟。短任务体感差不多,长任务差距会拉开。
DX(开发体验):这是真正的 trade-off。Anthropic 的 Sonnet 4.6 调过专门的 tool calling、long context 处理、reasoning chain;换成 DeepSeek 或 Llama,部分 skill 直接不能用,有些 prompt 翻车。README 里诚实写了:不是所有 backend 都支持 thinking blocks 和 tool calls。换句话说,你拿回了价格主动权,但放弃了部分 Claude Code 在 Anthropic 模型上调出来的”魔法”。具体掉哪些功能:Skills 自动调用 — DeepSeek 不一定能稳定触发;长 context — 32k 以下没问题,128k 以上 Llama 会丢中段;Bash + Edit 的 tool calling 链路 — DeepSeek 一两次 round-trip 可以,五六次 agent 自我修正循环就开始飘。
数据安全跟合规这条不能忽略。Anthropic 默认数据 30 天后销毁、训练用的那条单独 opt-in。换成 DeepSeek 或国内推理服务,数据留存政策得自己看 — 公司项目的代码不要随便丢。Ollama 完全本地这点是它最大的优势,代码一个 byte 都不出机器,适合金融、医疗、政府类项目。NVIDIA NIM 走 enterprise 私有部署也行,但配置成本不低。
谁该选哪条:
如果你是个人开发者,日常写小项目、改 bug、跑 demo,DeepSeek backend 最划算 — 价格 1/10、中文好、tool calling 大体能用。Ollama 适合代码不能上云的场景,但 Mac 内存要 32GB 以上才舒服。
如果你是团队/公司用,坦率说还是原版 Claude Code 更稳。Anthropic 跟 Claude Code 是一家做的,所有新 feature 第一时间适配,不会出现”Sonnet 5 出了但 proxy 还要等两周”这种事。省钱要算上调试成本。
如果你是研究/学习用,这个项目本身值得 fork 看代码 — 协议翻译层、streaming 处理、多 backend 路由,工程量不小,是一份不错的”中间件怎么写”的实战教材。重点看 messages.py 那一块的 OpenAI ↔ Anthropic Messages 协议转换逻辑,处理 tool calling 双向翻译的细节,以及 streaming response 的事件转换 — 这种”格式翻译 + 状态机”的代码,平时写业务很难碰到,看一遍长见识。
实测体感(社区反馈,我没亲跑):DeepSeek backend 跑日常 coding 任务大约能拿到 80-85% 的 Anthropic Sonnet 体验,够用但不顶级。Llama via Ollama 70B 大概 60-70%,适合”我只是想跑跑看”。NVIDIA NIM 免费层的 Llama 3.3 跑代码任务接近 75%,但限速比较紧。OpenRouter 路由可以选 GPT-5、Gemini Pro 这些,体感跟 Anthropic 接近,价格按 OpenRouter 计费,不算便宜但比 Anthropic 直接 API 灵活一点。
起手式:clone 仓库、设环境变量(目标 backend 的 API key 或 ollama localhost)、跑一行 bash 脚本启动 proxy server,然后让 Claude Code 把 ANTHROPIC_API_URL 指向 localhost:port,就能用了。整套流程 5 分钟,门槛比想象的低。如果你已经有 DeepSeek 账号,这件事今天下午就能跑通。
我自己的判断:这种 proxy 工具的真正价值不在”省钱”,在于把 Claude Code 这套优秀的 client 跟 Anthropic 模型解耦。一旦解耦,Claude Code 就不再是 Anthropic 的产品,而是开源社区的 IDE。这是开源社区惯用的”先借势、再独立”路径 — 早些年 vim/emacs 那批人,后来 vscode 这批人,把厂商工具变成行业标准,都是这条路。
如果半年后 free-claude-code 的稳定性追上来,这条路径会从 10% 用户扩到 30%,Anthropic 的 lock-in 优势就要重新算。Anthropic 团队大概率内部已经在讨论怎么应对 — 是封 API 头部识别、调高 enterprise 价格、还是干脆主动开放 protocol 抢回叙事主导权。哪一种走法都说明了一件事:Claude Code 的客户端优势已经被验证,接下来的牌局是关于”客户端跟模型能不能继续绑死”。
现在的版本不是终态,但方向对。值得 watch、可以试,但不必立刻全栈切走 — 用 Anthropic 跑生产、用 free-claude-code 跑实验和学习,这种混合用法成本最低、上限最高。等到下半年 DeepSeek 或 Llama 4 之类的模型把 tool calling 调到 95% 稳定,再来一次评估。
转给那个还在抱怨 Claude Code 月费却没试过 proxy 路径的同事 ↓
源链接在评论区 👇
关注 @svtransit1 · 写给真在用 AI 的人
#AI #ClaudeCode #DeepSeek #开源 #AI日报
原始来源:https://github.com/Alishahryar1/free-claude-code
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS