
微软放出了一整套开源的 voice 模型,从 ASR 到 TTS 到 realtime streaming 三件套全包。仓库叫 microsoft/VibeVoice,刚上 HN 13 个小时,已经 316 分。背后是 ICLR 2026 oral 一篇论文。这件事比单看 repo stars 重要 — 它意味着开源 voice 这条线,微软选择了"全栈交付"而不是"挑一个赛道做"。
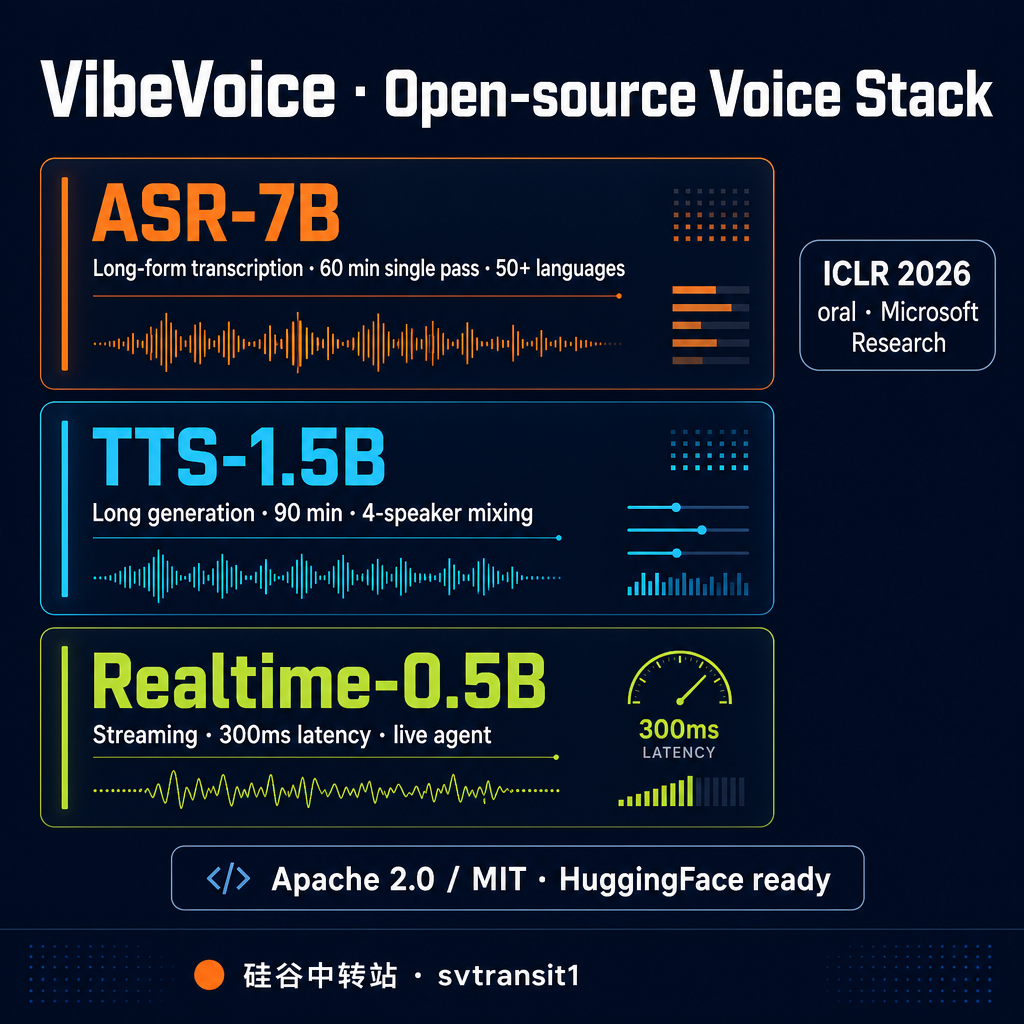
具体的三个模型,每个都有自己的目标场景。最大的 ASR-7B 走长 form,一次性能吃下 60 分钟单段音频,支持 50 多种语言,带 speaker ID 和热词。这个长度对 podcast、长访谈、会议录音的离线转写有现实意义 — 之前 Whisper-large 一段一段切再拼,容易丢上下文。一次过的好处是说话人识别和热词不会跨段崩。
中间档是 TTS-1.5B,90 分钟生成,4 个说话人可以混在一段对话里。这个规格瞄的是 audiobook、长 podcast 自动化、多角色 demo 这类场景 — 不是 30 秒短视频配音那种。
最有意思的是 Realtime-0.5B,300ms 延迟的 streaming 模式,文字进、声音出,几乎不卡。这个尺寸跟延迟,意味着可以塞进本地 voice agent、live chatbot、实时客服。0.5B 在 Mac M 系列上跑着压力很小,16GB 内存的机器都能 host 一个不掉帧的 voice 输出层。这一档的”低延迟 + 小尺寸 + 中文支持(论文里 50+ 语言含中文)”组合,以前只能在 SaaS 服务那里买到,价格按字符算。
技术上有一个细节值得提:VibeVoice 用 7.5Hz token 化 + diffusion 框架。普通 audio LLM 走 12-25Hz token,VibeVoice 把采样压到 7.5Hz,意味着每秒声音对应的 token 数更少,长序列处理效率更高。这是 60 分钟单段能跑通的底层支撑。代价是低采样率下的 fidelity 优化要靠 diffusion 反扩散补回来,效果要等社区跑分。
跟现有方案对比:Whisper 是 30 秒切片再拼,跨段说话人识别和热词都会断;Qwen3-ASR 长 form 也是分段。VibeVoice-7B 一次性吃 60 分钟,这是设计上的差异不是数字优化。如果实测稳定,长 form podcast 转写会被这个模型重新定义基准。
TTS 这边 Qwen3-TTS 12Hz 在中文圈口碑是”短句优雅”,VibeVoice-TTS 1.5B 是”长段稳定多角色”,定位不同不直接竞争 — 一个是 30 秒短视频强项,一个是 90 分钟 audiobook 强项。但 ElevenLabs 那条 SaaS 路线被夹得不舒服 — 它的卖点本来就是长 form + 多说话人 + 高自然度,VibeVoice 把这三个能力开源出来,定价模型受冲击。
Realtime-0.5B 是最有想象空间的一档。300ms 延迟 + 边写边说,这是 voice-first agent 的核心拼图之一。Whisper 没有 streaming,Qwen3-TTS 不是为低延迟设计的,Bark 太大太慢。VibeVoice-Realtime 如果中文质量能撑起来,Mac mini 配一个本地 voice agent 不再是科幻。
为什么这件事对中文圈独立开发者特别值得关注:开源 voice 这两年实质是 Qwen3-TTS 一家独大,英伟达 Riva 闭源、ElevenLabs 是 SaaS。VibeVoice 把 ASR + TTS + realtime 三个赛道一次性开源,三个尺寸覆盖 edge 到 server,等于直接给本地 voice agent 这条产品线一个完整起点。落地场景三类:本地 podcast 工作流(转写 → 编辑 → 多说话人重生成,全程不上云);voice-first agent(0.5B 塞进 Claude Code / Cursor 的语音输入,说话直接变 prompt);live commerce / customer support(边写边说 AI 主播脚本)。
想本周试一下的人,起手式很简单。HuggingFace 上三个 model card 都已经 live,pip install transformers 然后 from_pretrained 就能拉模型。粗略估,0.5B Realtime 在 M1/M2 Mac 上 16GB 够,7B ASR 需要 32GB+ 才舒服。Apache 2.0 / MIT 友好 license,可以直接 fork 进项目,不用顾忌商用边界。
测试顺序:先跑 Realtime-0.5B 单跑一段中文,看延迟在自己的机器上是不是真 300ms 级别;然后跑 ASR-7B 转一段已知中文长 podcast,跟 Whisper-large 做 diff,看错字率和说话人切分;最后才碰 TTS-1.5B,90 分钟 multi-speaker 是最难评测的,需要拿已有 audiobook 做对照。一次只换一档,不要全栈替换 — 出问题不知道是哪一层。判断”能不能用”的硬指标三个:中文清晰度、说话人切换的自然度、长 form 不漂移。这三条任何一条不及格,就回退到 Whisper / Qwen3 等待 v0.2。
值得盯的几个社区信号:HF 上的 download 数 + issue 区里中文 reproducibility 报告、HN/r/LocalLLaMA 第二周的 benchmark 帖、有没有出现快速 finetune fork 把中文质量再调一档。这些信号在 Whisper 早期出现过同样的曲线 — 一开始大家试,两周后 finetune 版开始爆发,三个月后变成生产级默认。VibeVoice 如果走同样路径,5 月底前能看到苗头。
需要保留的怀疑:微软给的是模型权重 + transformers 集成,但实际中文质量、长 form 稳定性、多说话人切换的自然度,要等社区两三周的实测。Anthropic / OpenAI / ElevenLabs 之前发声学模型都做过”benchmark 漂亮、真实场景翻车”的戏码,这种东西不试不知道。但即便保守估计 70 分能用,整套开源 + 三尺寸 + 友好 license 的发布方式,足以把开源 voice 的基线再往前推一档。下半年 Qwen3-TTS、Coqui XTTS、Bark 这些都会被迫回应。
最后一层意义:微软这种”全栈开源”姿态,跟前两年大力 push Phi、放出 GitHub Models marketplace 是一条线。它在跟 OpenAI 商业化路线做”开源对冲”。VibeVoice 不是单一模型发布,是战略信号 — voice 这个赛道,微软选了开源生态。ICLR 2026 oral 这个学术身份也不要小看,oral 意味 reviewer panel 一致认可创新性。学术认可 + 开源代码 + 多尺寸覆盖,这三件事同时齐,voice 领域上一次出现是 2022 年 Whisper。三年没有这种”全开”级别的发布。后续 Anthropic、Google、Meta 怎么回应,值得盯。短期不会撼动 Whisper / Qwen3-TTS 在各自细分场景的位置,中期有机会重新切分本地 voice agent 这个新赛道。这个赛道现在还没有明确的”标杆”,抢先卡位的人有大概率半年内就吃到红利。
转给那个还在用 Whisper 拼接长 podcast 的同事 ↓
源链接在评论区 👇
关注 @svtransit1 · 写给真在用 AI 的人
#AI #VoiceAI #LocalLLM #Microsoft #AI工具
原始来源:https://github.com/microsoft/VibeVoice
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS