
DeepSeek-R1 压到 INT2 混合精度,大约 200GB,精度保留 97.9%——这是 Intel 开源量化工具 Auto-Round 给出的最新一组数字,基本说明白了"模型小一档但用起来跟原版差不多"在工程上已经能落到生产级,不再是论文里的那种理想数字。这条对算 LLM 部署成本的人来说,是这一两个月最值得停下来看的开源工具更新之一。
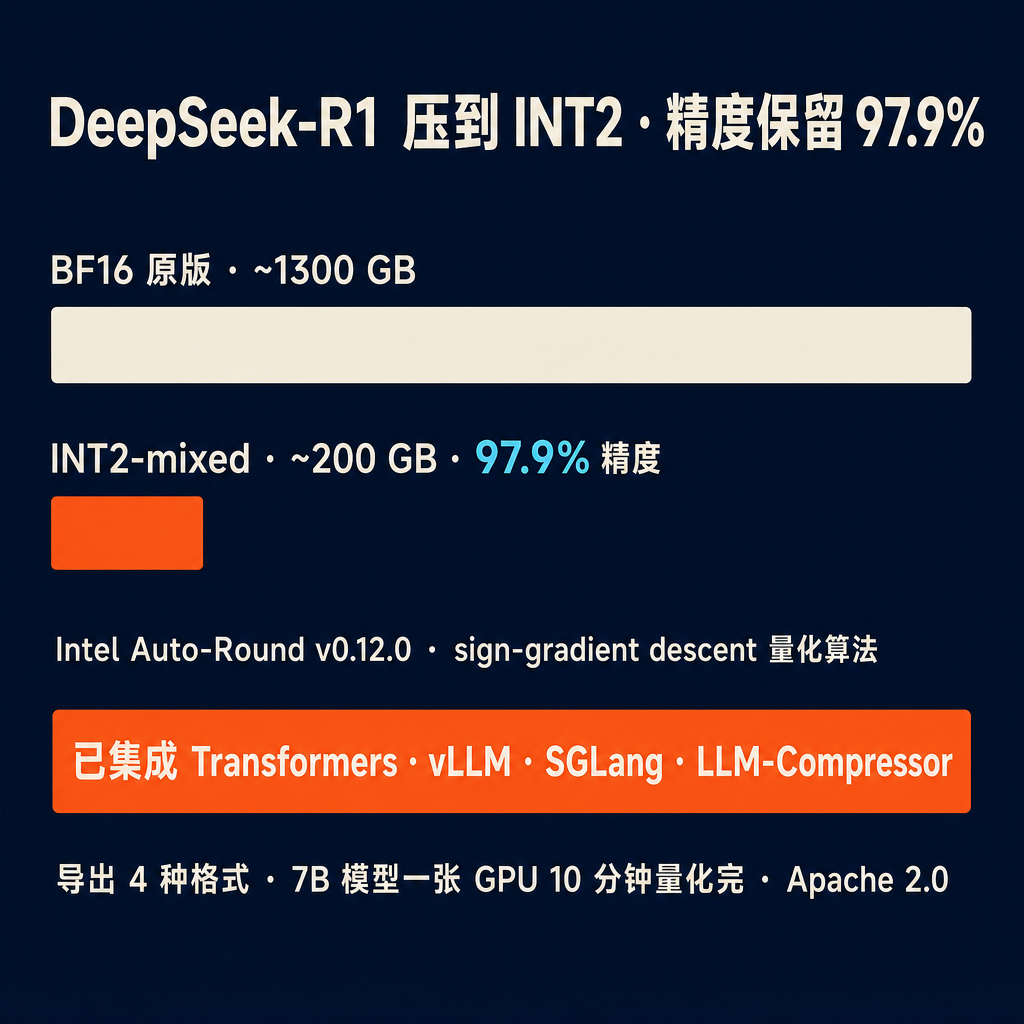
底层用 sign-gradient descent 算法,跟传统 round-to-nearest 比 accuracy 曲线明显更稳,Intel 自家的 SignRound V1+V2 论文打底,不是临时拼出来的脚本。生态接口已经齐全到几乎不用挑——Transformers、vLLM、SGLang、LLM-Compressor 这一票主流推理框架都集成进去了,Red Hat 把它直接写进官方 vLLM 量化文档,意思是你拿生产链路跑起来基本不用做额外胶水代码。导出格式也给到四种,你按部署侧偏好挑一个落地就行。LLM 部署成本里显存跟 inference 时延是最直接的两笔钱,从 16 位降到 4 位理论上 4 倍小,降到 2 位 8 倍小,但只有量化算法压得住精度差才有真意义——这次 97.9% 这个数字,是把”模型小一档但用起来跟原版差不多”从论文级别推到能进生产的工程级别的代表性结果。如果你最近在算自己跑大模型的钱,或者在帮团队选量化路线,这一晚上值得装下来跑一遍——尤其是已经在 vLLM 或 SGLang 上跑生产推理的开发者,接进来几乎是零成本。Apache 2.0,v0.12.0。
链接 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #量化 #开源 #LLM
原始来源:https://github.com/intel/auto-round
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS