
Kelsey Piper 把 Claude Opus 4.7 拿来做了一组实验,结论让她准备改写自己未来 20 年的网络习惯——AI 只需要 150 个字,就能从一段她从没公开发过的文字里把她认出来。
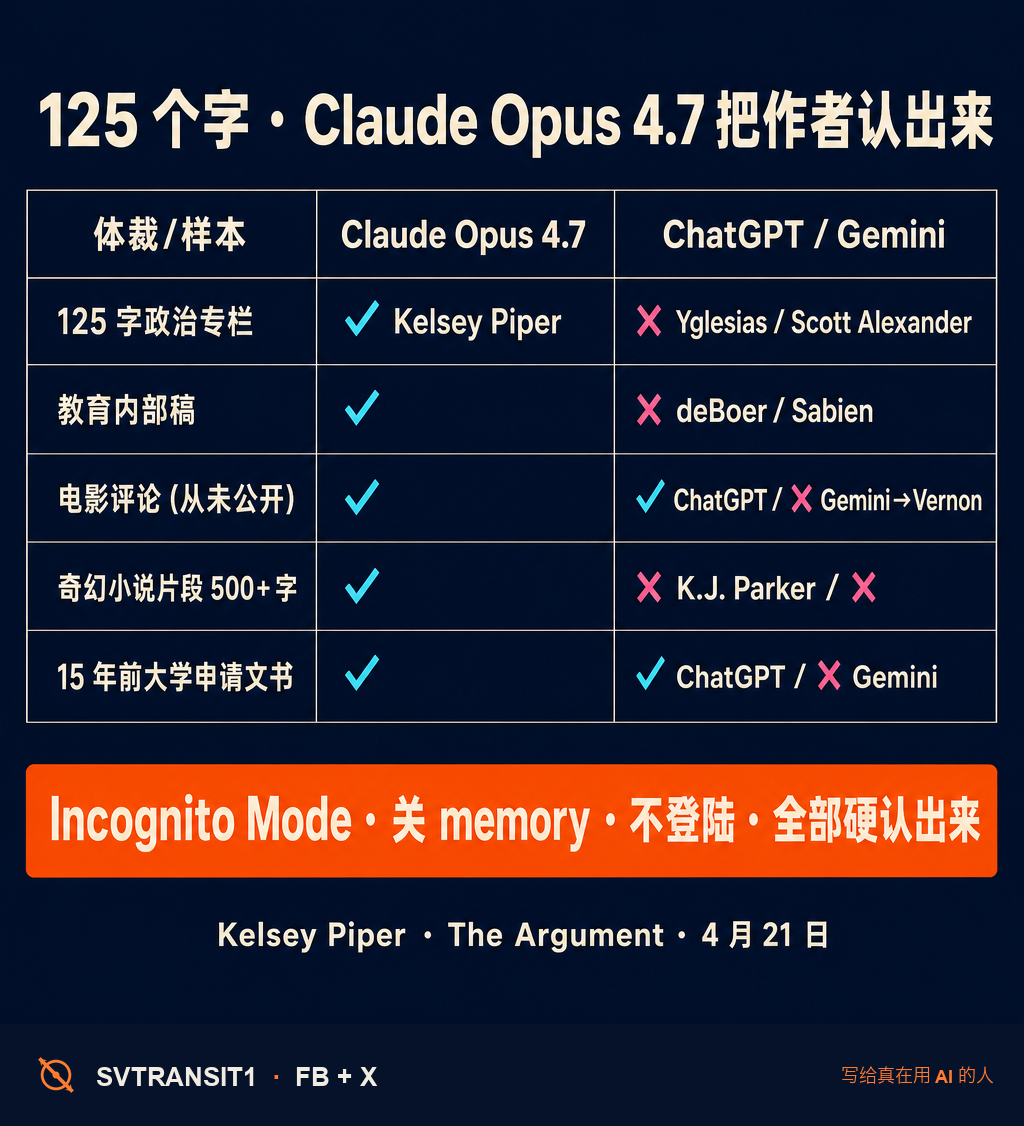
她做的事情很直白。开了 Claude 的 Incognito 模式,关掉所有 memory 跟账号关联,把不同时期、不同体裁的写作样本扔进去,问 Claude:”猜猜这是谁写的。”
第一组,125 个字,是她写的一篇政治专栏开篇——风格、语气、节奏都是她。Claude Opus 4.7 上来就说:”Kelsey Piper。”对。同一段文字交给 ChatGPT,ChatGPT 猜的是 Matt Yglesias;交给 Gemini,Gemini 猜的是 Scott Alexander。这是 Opus 4.7 这个版本特有的能力,GPT 和 Gemini 都没追上来。
第二组,她从没在公开渠道发过的一篇教育类内部稿件——还在她写过的话题范围里,但写法没公开过。Claude 又说”Kelsey Piper”,对了。ChatGPT 这次猜的是 Freddie deBoer,Gemini 猜的是 Duncan Sabien。两个都错了,但都是同温层的著名作者——意思是 ChatGPT 和 Gemini 知道这写作”长得像谁”,但归错了人。Opus 抓得更细。
第三组难度直接拉到顶。她把一篇电影评论扔进去——这是她”从来没在公开渠道写过”的体裁。Claude 说”Kelsey Piper”,对。ChatGPT 这次也对了,Gemini 错(它猜的是 Ursula Vernon)。
第四组她加了个长一点的奇幻小说片段——五百多字、虚构叙事、跟她的非虚构日常写作风格完全不同。Claude 还是对了。ChatGPT 这次猜的是 K.J. Parker,大概是因为风格里有英国奇幻味。
最后一组,她拿出一篇自己 15 年前写的大学申请文书,她形容那时候的文笔”差到现在重读会脸红”——句子结构、词汇选择、节奏跟她现在的写作完全不是一回事,AI 训练数据里几乎不可能有那篇文章。Claude 又对了。这一次 ChatGPT 也对了——但 Gemini 还是错。
她也试了一组”反向校验”,把一个朋友的私密 Discord 消息丢进去——这次 Claude 失败了,识别不出。这条排除了”Claude 在通过任何账号或 cookie 上下文偷偷看你身份”的解释——它真的是从文本本身去抓的。
她最后那段反思值得抄一遍。她注意到:Claude 在每次答对之后都会编一段解释,什么”你倾向于用嵌套从句”“你的反讽姿态比较克制”“你转折时喜欢用一个短句压住前面的长句”——但她自己读这些解释,半信半疑。她的判断是:这些解释是 AI 在事后造的逻辑包装,看起来像福尔摩斯式的推理,但其实没有发生那样的”推理”过程。真正发生的事情是模型把”Kelsey Piper”这个答案在一个高维度的矩阵里算出来了一个最大值或最小值,具体走的是哪条神经元她不知道,Claude 自己也不知道,Claude 给你的”理由”很可能就是它现编的。她原文用了一句很狠的话:AI 是终极的 CYA 胡话机器——给你一个有用的答案,再附上一段听起来很合理但不一定真的能解释它怎么想出来的话。
几个细节值得单独点出来。一是这是 Opus 4.7 这一代特有的能力,GPT 跟 Gemini 在前几组测试里全错,只在最容易那两组(15 年前文书 + 电影评论)才追上一部分。意思是这个能力不是”所有大模型都会的事”,是 Anthropic 这一版的训练 data + 训练 objective 撞出来的。二是 Kelsey 自己测试用的是 Incognito 模式 + 关 memory + 不登陆,排除了 Claude”作弊”通过账号上下文识别的可能性。换句话说,这真的是从 125 个字里硬认出来的。
往后看一件事。Kelsey 是写作量大、公开作品多的那一类人——AI 通过她过去十几年累积的几十万字训练材料,提炼出了她写作的某种隐形指纹。绝大多数普通人没那么多公开写作,但每年我们留下来的网络痕迹都在变多——Reddit 评论、邮件、Discord 消息、博客、社交媒体动态,数量都在累积。她的判断是:这种”AI 通过文风去匿名”的能力,会随着模型升级跟你公开文字增多,逐年扩大覆盖面。今天它认得 Kelsey Piper,明年它认得每个写过 50 篇 Reddit 帖子的人,后年它认得任何在 Discord 公司服务器里发过两年消息的员工。
这件事最直接的影响,是过去三十年我们靠”网名 + 不署真名”建立的那套准匿名,在一个有点写作量的人身上,正在失效——失效的不是某一种平台、某一种登录方式,是行为本身。你写得越多,你就越没法匿名。这是一个换 VPN 换不回来、换浏览器换不回来、加 incognito 换不回来的问题——你的指纹是写出来的,留在每一句话里。
具体到中文写作圈,这件事的发酵节奏可能会比英文圈慢一点,但不是不会到。中文写作的指纹同样存在——你怎么用排比、怎么用反问、怎么调反讽语气、爱用哪几个虚词,这些都是可以被模型抓的特征。早几年 AI 在中文上的”写法识别”做得不够好,主要是中文训练量比英文小一档,但这一两年随着多语言模型走齐,差距在快速收窄。
实际操作上,如果你现在在做匿名爆料、独立调查报道、或者在工作场合需要保护自己身份发表观点,得开始把这件事算进风险模型里。换号、换 VPN、用临时邮箱、走 Tor 都还是基础动作,但在文风这一层,如果你过去十年在公开网络写过东西,你已经有了一份留在 AI 训练数据里的指纹——下次你想匿名说点话,Claude 那边可能比你想的更快认出你。
链接 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #ClaudeOpus #隐私 #AI能力
原始来源:https://www.theargumentmag.com/p/i-can-never-talk-to-an-ai-anonymously
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS