
本地跑 Qwen 3.6 + 一个开源 agent,SimpleQA 打到 95%。再不用为 deep research 续 200 块的订阅了 —— 至少作者是这么报的。
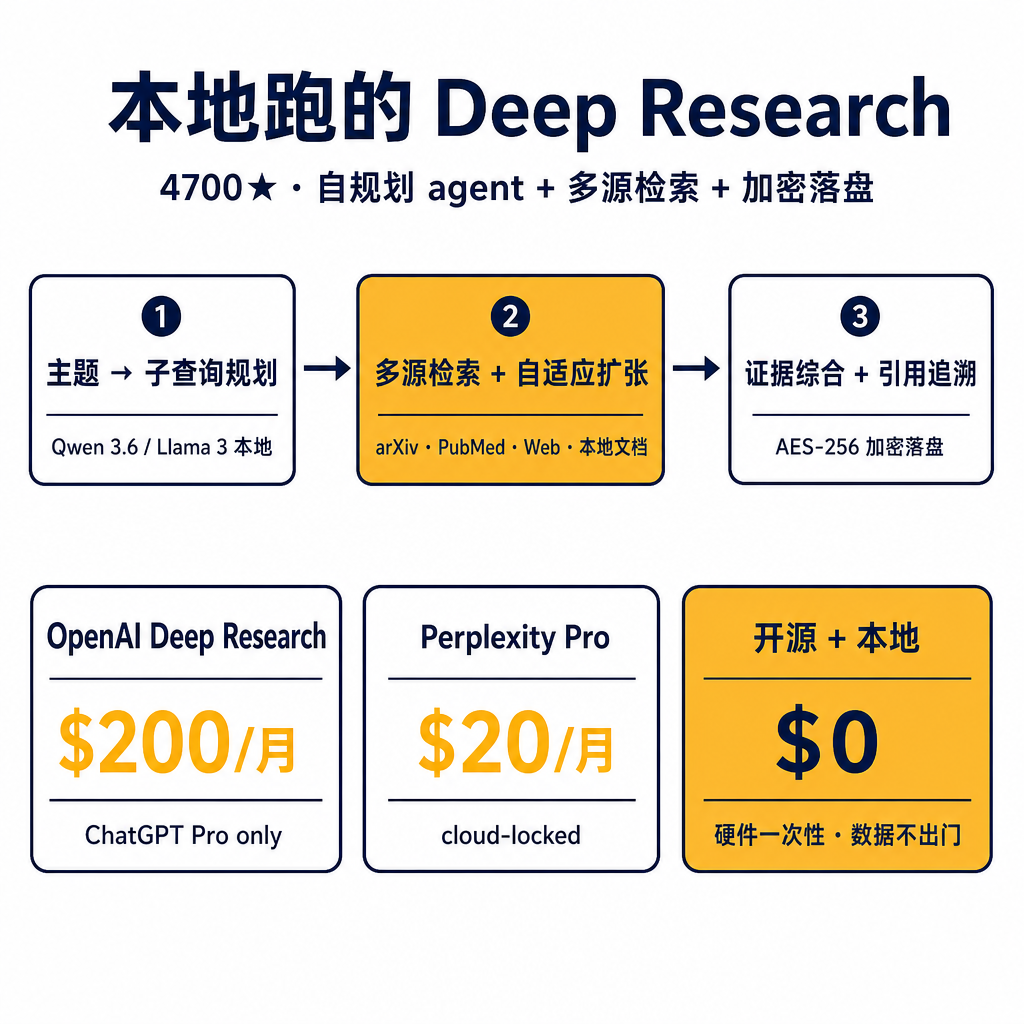
GitHub 这两天有个 LearningCircuit/local-deep-research 在涨星,4700★ 起步、今天还在更新。它把 OpenAI Deep Research、Perplexity Pro、Anthropic Research 这条赛道的产品形态拆下来开源了:你给它一个研究主题,agent 自己规划检索、跑搜索、读论文、做交叉引用、写综述,最后吐出一份带 footnote 的 markdown 报告。区别是这条 pipeline 全程可以跑在你自己的机器上,不联网那一截也能跑(联网的部分只是搜索抓取)。
整套架构很模块。LLM 这一截可以接 Ollama、LM Studio、llama.cpp 本地起的 Qwen 3.6 / Llama 3 / Mistral,也支持 OpenAI、Anthropic、Google 的 API,按研究主题切换 —— 比如检索综合让本地 Qwen 顶,最后那一段写作让 Opus 收尾,混合架构是这工具最实用的姿态。检索源接了 arXiv、PubMed、SearXNG / web 搜索引擎、还有你本地某个文档目录,加起来 10 多个;可以单独打开关闭,做医学研究时只走 PubMed,做技术调研时只走 arXiv + web,做内部知识管理时只走本地文档。安装本身很轻 —— 一个 Python 包加上 Ollama 已经在跑的话,几条命令就能起来;docker compose 也有,团队部署不算复杂。
agent loop 那条线值得单独说一下。它不是单纯的 RAG —— 给主题之后,agent 会先规划检索路径(关键词、子查询、时间范围),跑搜索,读结果,根据读到的内容再决定下一轮要不要扩张查询、要不要换源;中间维护一个证据池,每条结论都强制要求引用至少 1-2 条来源。这种”自规划 + 自评估”的 loop 是 OpenAI Deep Research 那条产品的核心,开源版本把它做出来 —— 完成度可以争论,但产品形态不再是黑盒了。
最有意思的一块是存储层。默认用 SQLCipher 加密的 SQLite 做 knowledge base,每一次研究跑下来的中间证据、引用、推理链都 AES-256 加密落盘,作者明确写”什么都不离开你的机器”。这种姿态在隐私敏感的工作场景里 —— 律师写案件 brief、医生跑文献综述、企业研发查内部专利 —— 不只是噱头,是合规要求。
作者贴的硬数字是 SimpleQA 跑到 ~95%(用 Qwen 3.6 测的),这个先打个问号 —— SimpleQA 本身偏简单事实 QA,不能直接外推到复杂多跳研究任务,作者自报数据没第三方复测。但就算砍一半,对一个能跑在 16G / 24G 显存消费机器上、不收订阅费的开源工具来说,也已经够实用。OpenAI Deep Research 是 ChatGPT Pro $200/月 only 的功能,Perplexity Pro $20/月,Anthropic Research 包在 Max 里。开源 + 本地这条路把订阅成本砍到接近零,硬件成本一次性。
举个真实场景。假设你要做一份”2026 上半年中国 AI 视频生成赛道公司盘点”的研究 —— 这种活之前丢给 Perplexity 或者 ChatGPT Deep Research,等十几分钟拿到一份带引用的报告,还能用。换成 local-deep-research 这条路:你给主题 + 一些初始关键词,agent 起 Qwen 3.6 在本地跑规划,去 web 搜各家公司的融资新闻、技术博客、GitHub 主页,去 arXiv 抓相关论文,最后把内部一份你之前整理的 Notion 导出 markdown 也读进来交叉对比。整个跑完,原始证据 + 推理链全部加密落在你自己机器上,没有一条数据离开本地(除了搜索请求本身)。
我没自己跑过,但能预判几个边界。第一,本地 LLM 在长 context 综合上还是吃亏,跑 30+ 条 arXiv 摘要做交叉引用的时候,Qwen 3.6 的吞吐和推理深度压不过云端 Opus,复杂研究的尾部 5% 质量差距很难抹掉。第二,搜索源里的中文学术(CNKI、万方、知网)目前没看到原生支持,做中文领域 research 要二次集成,国内 paper 抓取还有反爬虫这关。第三,加密 knowledge base 是个亮点也是个负担 —— 每次读写都要 hash,复杂跨库查询的延迟会被放大,跑一个几千条引用的项目时性能会感觉到。
但更大的信号是产品形态本身。OpenAI 把 Deep Research 包成 Pro plan only 的功能、定价 $200/mo;Anthropic Research 作为 Max 的一部分。这条赛道的护城河现在被开源工具一层一层戳穿 —— 之前是 Claude Code 被 deepclaude 截了一道,今天是 Deep Research 被开源 agent + 本地 LLM 截了一道。模型那一截商品化、产品形态那一截开源化,剩下值钱的是分发渠道、研究质量评估系统和长期记忆 —— 这些更慢、更难复制的东西,才是下一个壁垒。
谁该试一下:手上有一台 24G 以上显存机器、跑 Ollama 已经熟、对订阅成本敏感、做的内容跟内部数据混合多 —— 这群人最划算。谁先别动:依赖最尾端 5% 推理质量的研究、要写发表级别的论文综述、不想花两个晚上调本地 LLM 部署 —— 这种场景目前还是云端大模型 + 厂商 Deep Research 更省心。中间地带的人 —— 写技术博客、做行业调研、内部知识整理 —— 用本地版的体验大概率已经够好。
repo 地址放评论区。值得跑一下,特别是有隐私需求或者已经买够订阅的人。
原始出处 · 第一条评论拿
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LocalLLM #DeepResearch #Qwen #AI工具
原始来源:https://github.com/LearningCircuit/local-deep-research
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS