
本地跑 70B 以上的 LLM,选 Nvidia Blackwell 还是 Apple Silicon?这周 arxiv 上一篇标题叫《Silicon Showdown》的实证研究把这件事拆得相当干净——结论不是简单的"哪家赢",是"两条架构在不同 trade-off 上各赢一头",一刀切的选型基本走不通。
研究是 Allan Kazakov 跟 Abdurrahman Javat 做的,5 月 1 号上 arxiv,系统测了消费级硬件上跑 70B 以上权重模型的性能与代价。论文的核心方法是把每条架构内部的 trade-off 单独量化出来,而不是只跑一个表面跑分。
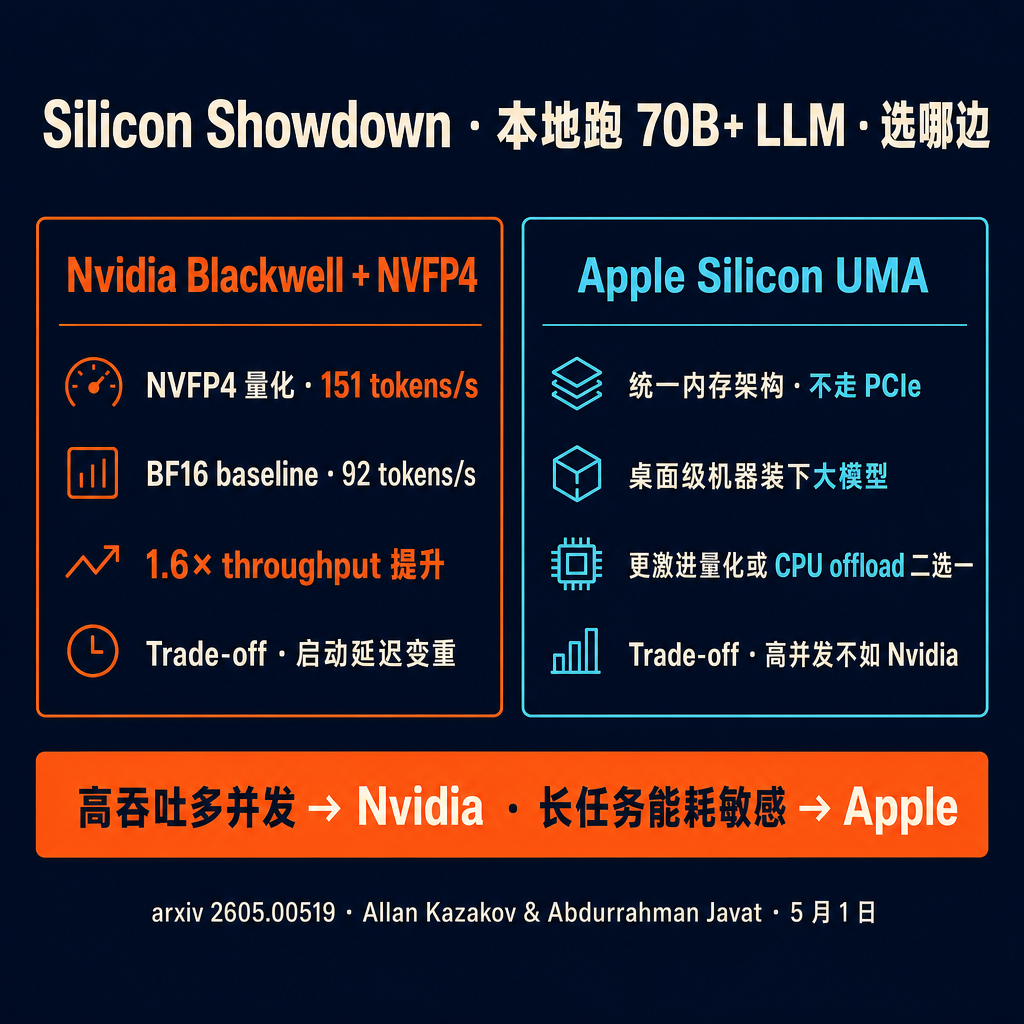
第一个有意思的发现在 Nvidia 这边。Blackwell 架构的 TensorRT-LLM 栈里出现了一个作者称为 “Backend Dichotomy”(后端二分)的现象——你想用上新的 NVFP4 量化格式,确实能把吞吐量从优化过的 BF16 基线的 92 tokens/s 推到 151 tokens/s,1.6 倍提升,但代价是启动延迟变重、运行时约束复杂,你必须在”启动得快但慢慢出”跟”启动得慢但出得快”之间二选一,这个 trade-off 不能两头都吃。这一点在工程实践里特别 关键——如果你做的是 batch inference,启动一次跑一晚上,选 NVFP4 的吞吐红利几乎是免费午餐;但如果你是做 interactive serving、用户敲一行就要等响应,那启动延迟变重这件事直接落到用户体感上,可能反而比慢一点的吞吐更难接受。同一块 Blackwell 卡,在两种部署模式下的最优配置完全相反。
NVFP4 这个格式本身值得多说两句。它是 4 位浮点格式,跟之前主流的 INT4 量化最大的区别在于保留了浮点的动态范围,这意味着在精度跟吞吐之间能拿到更好的平衡。Nvidia 这一代硬件原生支持 FP4 的硬件加速指令,意思是这不是软件层面”凑出来”的优化,是芯片设计层面的提速,所以 1.6 倍的差距大概率会随着 TensorRT-LLM 后续版本进一步拉开。但论文同时指出,NVFP4 的工具链成熟度还在追,有些主流模型还没有完整的 NVFP4 量化路径,需要走自己的转换脚本。
Apple Silicon 那边作者用了不少篇幅描述统一内存架构(UMA)在大模型场景的优势——核心要点是,iGPU 跟 CPU 共享一块物理内存池,不需要在 PCIe 总线上来回搬运权重,跑大模型时的有效内存容量比同价位的独立 GPU 大得多。论文里量化了 Apple Silicon 在能效比上的优势(具体数字可以去看 paper 原文)。更值得记住的是工程层面的二选一:大参数模型在 M-series 上靠 UMA 的内存优势能整块装下,在消费级 Nvidia GPU 上面对同等模型,你要么走更激进的量化方案换质量下降,要么走 CPU offload 换吞吐下降,这是同一道选择题在不同硬件上得到的不同答案。
实操上的启示也挺直白。如果你的工作流以”高 throughput 服务多并发请求”为主,Blackwell + NVFP4 仍然是最强组合,代价是工程复杂度。如果你的需求是”在一台机器上跑大模型做长任务、能耗敏感、并发不高”,Apple Silicon 是越来越难忽视的选项,尤其考虑到 M-series 的高配版本目前能配置非常大的统一内存(具体上限以 Apple 官方当下 SKU 为准),以前必须靠 datacenter 级 GPU 才能装下的模型,现在桌面级 Apple 机器也能整块装下。这种场景的典型用户是个人开发者跟小团队——不需要每秒服务一千个请求,需要的是”我能在桌面机上跑 70B、做我自己的 fine-tuning、做我自己的 agent 实验”,这一档需求过去两年是被高端独立 GPU 的价格挡在门外的。Apple Silicon 不便宜,但相比同等内存容量的 datacenter 卡,数量级差距开始变成”贵但能买得起”。
中间还有一档值得提:不少团队的实际配置是混合架构——Mac Studio 做开发跟实验、Nvidia 卡做生产 serving。论文没直接说这件事,但从 trade-off 表里推过去就是这个结论。这种”开发用 Apple、上线用 Nvidia”的工作流过去半年在国外 LLM 应用团队里悄悄变多,《Silicon Showdown》这一篇相当于把这种实践的工程理由白纸黑字写出来了。
往大了看一件事。这一两年消费级 LLM 推理硬件的故事,是从”只能选 Nvidia”变成”两条独立路径各有优势”。论文没有给出一个简单的赢家排序,反过来这才是它最实在的贡献——它把”选硬件”这件事从”看哪家发布会更帅”拉回到”明确你的 trade-off 优先级再选”,为接下来一两年的 LLM serving 工程决策提供了一个可对照的 baseline。
这条 baseline 的意义在于它把方法论摊开了——之前不少硬件比较只给一组排行,这一篇把”为什么”挖到位,你拿这套 trade-off 框架去看任何一代新硬件,都能更快定位它在你工作负载下的真实位置。
谁该读这一篇。如果你做 LLM serving 工程,直接读论文,那张性能对照表是接下来选硬件的工作底稿。如果你是 LLM 应用开发者,关键 takeaway 不是具体数字,是”硬件选型已经从一维变成多维,你的工作负载形态决定哪条路适合你”。如果你是采购/CTO 这一档需要做大额硬件预算决策的角色,这一篇值得让工程团队拿出来 debrief 一次,把贵公司的工作负载放在这个 trade-off 框架里走一遍——可能会发现过去采购的硬件,其实在你的实际负载下不是最优解。
链接 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #硬件 #Nvidia #AppleSilicon
原始来源:https://arxiv.org/abs/2605.00519
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS