
一台 M3 Pro Mac,跑 45 分钟,你能从零训出一个会写莎士比亚体英文的 GPT。这件事在 2026 年的中文 AI 圈,被严重低估了。
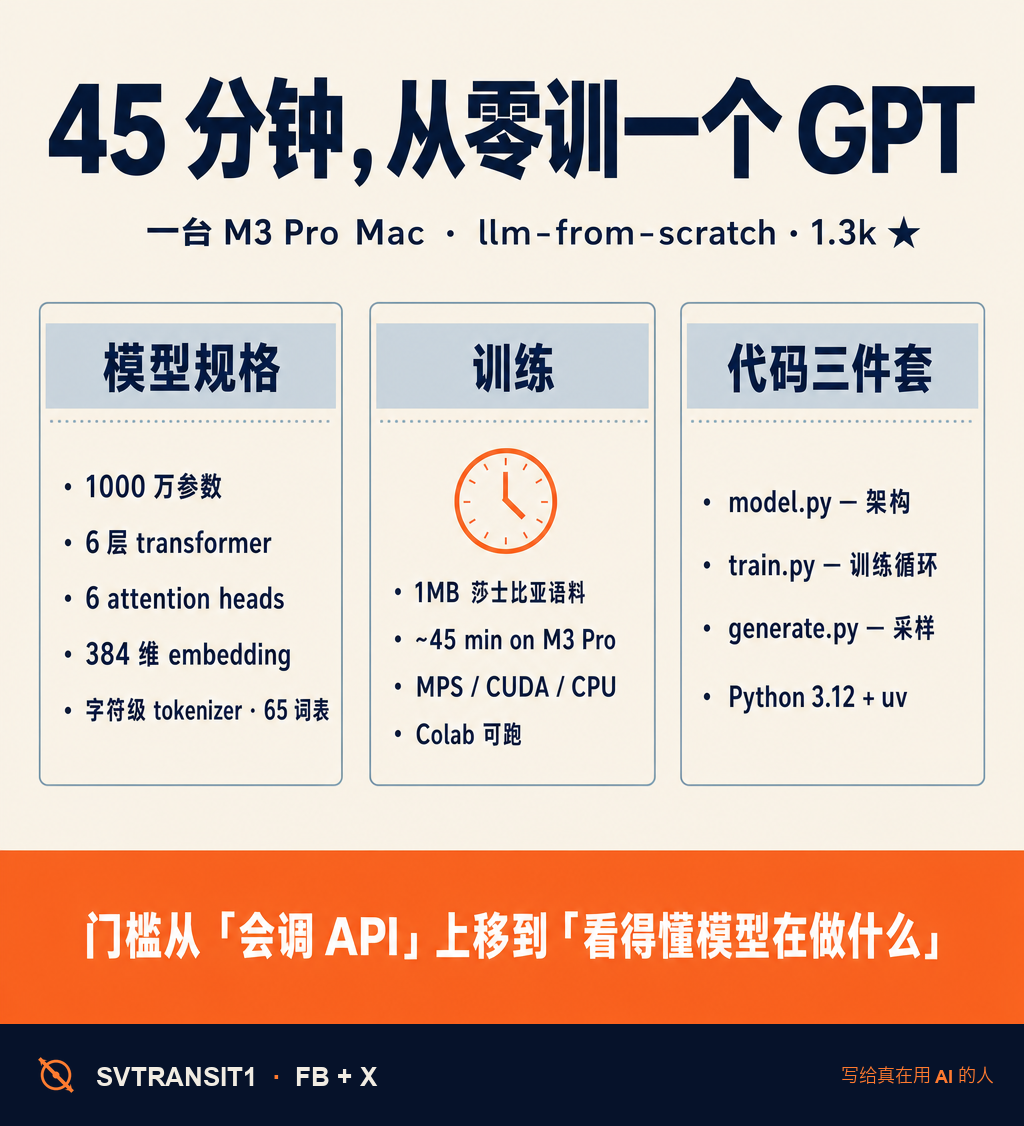
GitHub 这周冒出来一个 1.3k 星的仓库——llm-from-scratch,作者 angelos-p,六节课的 workshop 形式,明确致敬 Karpathy 的 nanoGPT。默认模型 1000 万参数:6 层 transformer、6 个 attention head、384 维 embedding,字符级 tokenizer,词表只有 65 个 token。训练数据是莎士比亚全集,大小 1MB。这套配置在 M3 Pro 上跑完一轮训练 45 分钟。Apple MPS、CUDA、CPU 都跑,Colab 也行。
代码就三个文件:model.py 写架构,train.py 写训练循环,generate.py 写采样推理。Python 3.12+,uv 装依赖。六章顺序走完——tokenization、transformer 架构、训练 loop、文本生成、整合、竞赛——你手上会有一个能从字符 prompt 续写英文的 GPT-mini。
为什么值得花一个周末?
过去一年的中文 AI 内容,大多数在教调 prompt、接 API、RAG 一个文档库。这些都是上层应用。底下那个会预测 next token 的小机器到底怎么转,绝大部分使用者从来没看过它的肠子。把 train.py 的 80 行核心代码读一遍,transformer 没有想象中神秘——一个 embedding 表 + 几层 attention + 一个 softmax,就这么简单。理解它的人,在用大模型时的 mental model 跟没看过的人是两个东西。
更值得拎出来的设计选择,是字符级 tokenizer。作者特意没用 BPE,理由写在 README 里:”小数据集上,大部分 token bigram 出现次数太低,模型根本学不会”。这一行注释比整个项目说明都值钱。它在告诉你:tokenization 的选择跟你的数据规模深度绑定,一刀切的”用 GPT-2 tokenizer 准没错”在 1MB 语料上会翻车。这种 trade-off 思维,比”再加 100 万行训练数据”更接近真正的工程感。
2026 年 AI 圈的人才门槛,从”会调 API”上移到”看得懂模型在做什么”。Karpathy 的 nanoGPT 当年是给研究生看的,angelos-p 把这个门槛压到了”有 Mac 就行”。
仓库就在 GitHub,自己 clone 下来跑一遍 train.py,比读完这篇帖子收获大十倍。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#LLM #PyTorch #AI教育 #nanoGPT #AI工具
原始来源:https://github.com/angelos-p/llm-from-scratch
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS