
让前沿 AI agent 上线真实网站做 153 个任务,7 个顶级模型最高分:33.3%。这是 UBC + Vector Institute 这周发布的新基准 ClawBench 的成绩单。
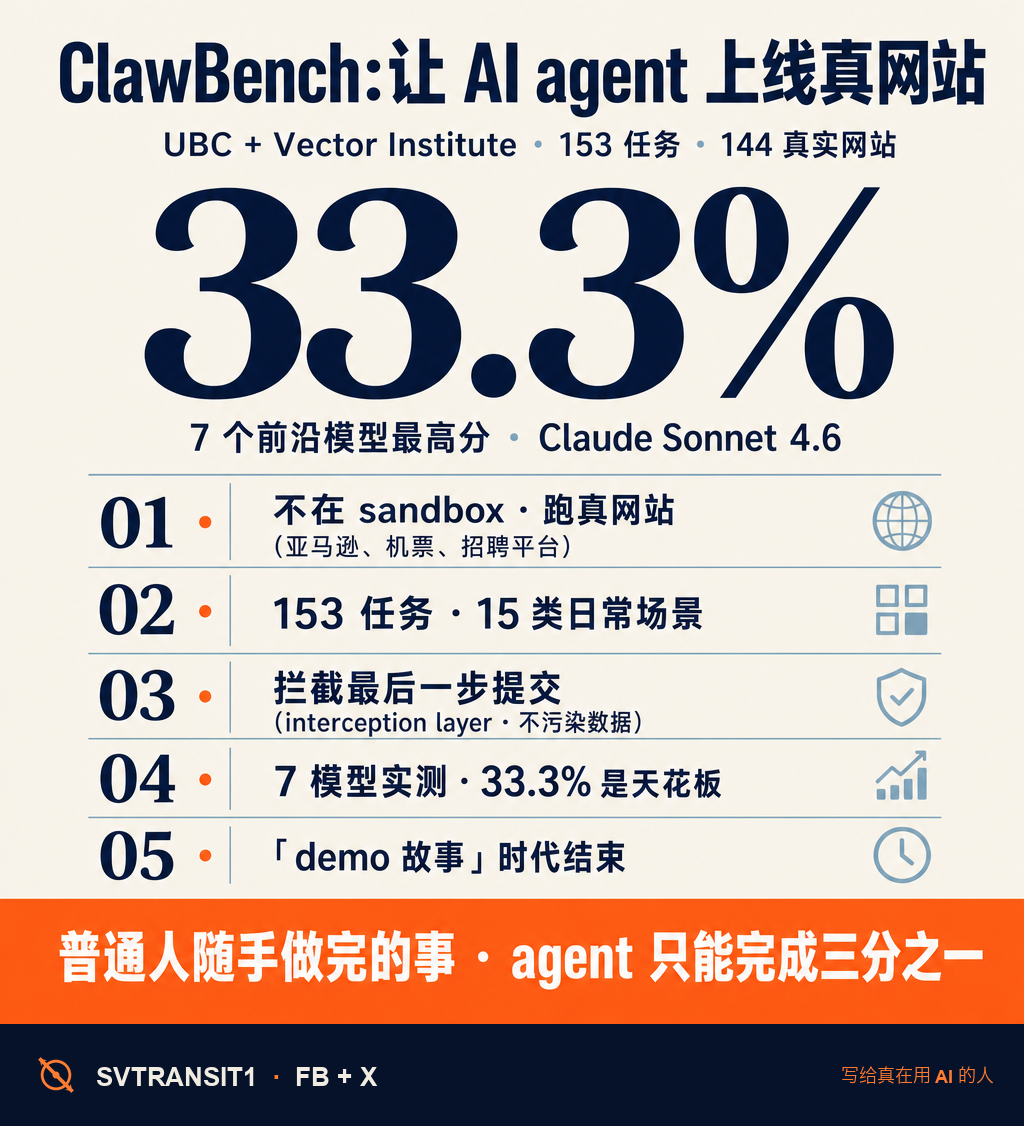
它跟以前那些 agent benchmark 不一样的地方,值得一一拆开看。
-
不在 sandbox,跑真网站
过去基准多数是离线静态页面。ClawBench 让 agent 在 144 个真实生产环境网站上跑——亚马逊、机票、招聘平台、医院预约系统这些。一切动态加载、cookie、登录、A/B test、广告弹窗,全是真的。
-
153 个任务 · 15 个类别
覆盖完成购物、预约面试、提交求职、订机票等 15 个日常网络场景。任务本身没有任何「巧妙陷阱」,就是普通用户每天会做的事。
-
拦截最后一步提交
测试方式很取巧——团队加了一层 interception layer,在 agent 发出最终 submit 请求那一刻拦下。订单没真下,数据没污染,真人没收到错误邮件。工程层的硬功夫。
-
7 个前沿模型,33.3% 是天花板
闭源开源都测了。Claude Sonnet 4.6 拿到最高的 33.3%。换句话说,普通人随手就能做完的网站任务,前沿 agent 只能完成三分之一。
-
这数字告诉我们什么
过去一年 demo 视频和 X 上的截图给了大家一个错觉——「agent 已经能上网替你处理事情了」。ClawBench 把这个叙事直接打回原型。它证明的是:agent 在真实生产网站上的可靠度,跟受控环境差好几个数量级。
我看下来感觉是这样:2026 年 agent 评测的可信度,正在从「show case 演示」往「跑在真生产环境上」转移。下半年所有大厂的 agent 升级,都得拿 ClawBench 这种数字过线才算数。33.3% 是当前的天花板,这个数字会被快速刷新——但也只能在真测试里刷新。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AIagent #ClawBench #Anthropic #AI评测 #AI工具
原始来源:https://www.clawbench.com/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS