
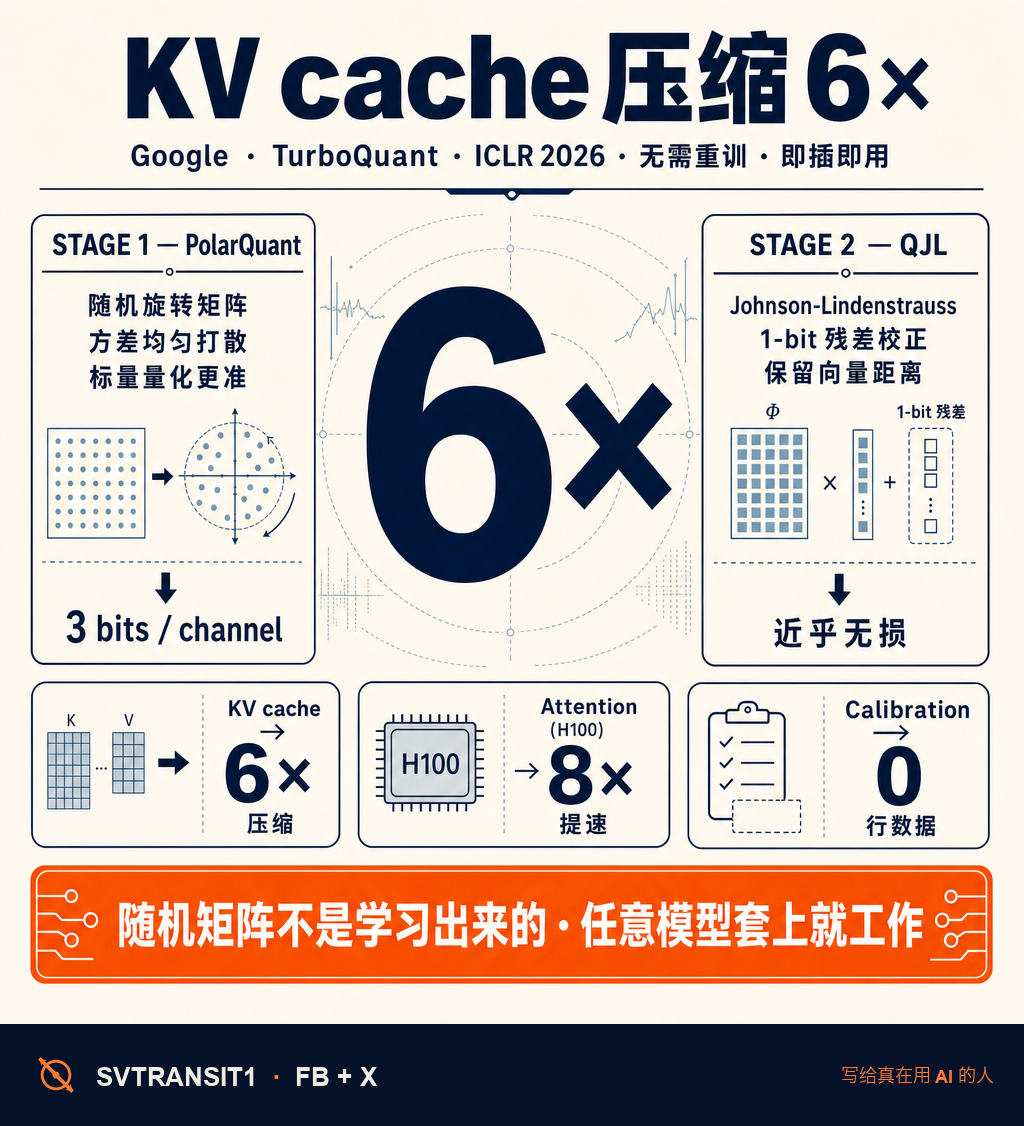
KV cache 直接压到原来的六分之一,attention 在 H100 上跑快八倍。无需重新训练,任意模型即插即用。
这是 Google Research 三月发的 TurboQuant,被收进了 ICLR 2026,这周在国内技术圈开始转。我读了一遍论文跟实现,把它的工程逻辑拆给你看。
先说背景。LLM 推理的真瓶颈早就从算力侧搬到了显存侧——具体说,搬到了 KV cache 占用。一个 long context 模型把上下文撑满,一张 H100 80G 显存基本被 cache 吃光,batch 跟不上,服务成本算不出。过去解法多数靠 4-bit 量化,精度掉一截,长尾任务出问题。
TurboQuant 走的是另一条路,两步。
第一步叫 PolarQuant。给每个 key / value 向量先乘一个随机旋转矩阵,把方差均匀打散到所有坐标上。旋转完之后每一维都接近标准正态分布,标量量化一上去就准。妙在数学上这个旋转完全可逆——你保留旋转矩阵,推理时反向乘回去,信息没丢。
第二步叫 QJL,基于 Johnson-Lindenstrauss 变换。这是个数学工具,可以把高维向量压成低维,同时保留向量之间的距离关系。论文用 1-bit 残差去校正第一步的量化误差,两步加起来,3 bits / channel 实现近乎无损。
最关键的工程价值在最后一句:整个流程用的是随机矩阵,不是学习出来的。意思是你不用 calibration run,不用喂任何数据,任意模型直接套上去就工作。
实测数字:KV cache 内存压缩 6x;attention 推理速度在 H100 上 8x;下游 benchmark 完全保持原模型成绩。Rust 实现已经在 GitHub 开源,RecursiveIntell/turbo-quant 仓库里可以直接读。
我看下来感觉是这样:long context 模型跑不起的成本曲线,被 TurboQuant 这一手往下砍了一刀。下一波 100K+ context 推理服务,大概率会带着这套压缩方案上线。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#TurboQuant #LLM #KVcache #ICLR2026 #AI推理
原始来源:https://research.google/blog/turboquant-redefining-ai-efficiency-with-extreme-compression/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS