
Salvatore Sanfilippo——也就是写 Redis 的 antirez——这周悄悄发了一个 GitHub 仓库,叫 ds4。一句话定位:让 DeepSeek v4 Flash 跑在你的 Mac 上,用 Metal 做 GPU 加速。
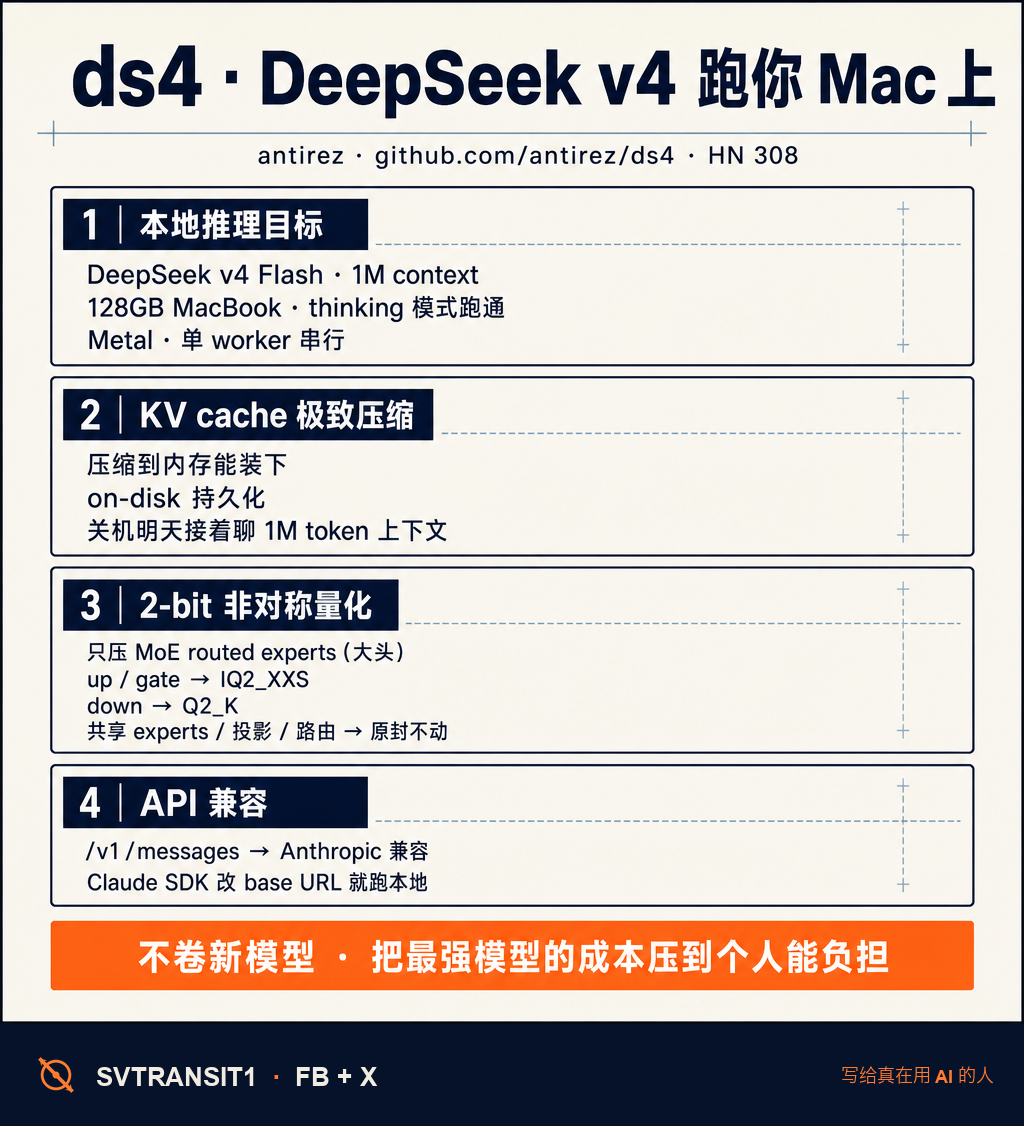
我把它的工程细节拆给你看。
先说目标。DeepSeek v4 Flash 这种规模的模型,正常情况下你别说本地跑,云上跑都要花心思。antirez 的目标更激进——让一台 128GB RAM 的 MacBook 把 thinking 模式整个流程跑通。这件事被很多 ML 工程师认为「物理上做不到」。
第一刀切在 KV cache 上。ds4 把 KV cache 压到极致,而且支持把 cache 写到磁盘上做持久化。意思是你跟模型聊一个 1M token 的长上下文,关掉电脑明天再开,接着聊就是。
第二刀切在量化上。这是整个项目最妙的设计。普通 2-bit 量化整个模型一刀切,精度会死。ds4 走的是非对称量化:只把 MoE 路由的 experts 压到 2 bit(up 跟 gate 用 IQ2_XXS,down 用 Q2_K),共享 experts、投影矩阵、路由层这些「关键肌肉」原封不动。MoE 模型大部分体积在 routed experts 里,只压它,模型瘦下来但智商不掉。
推理这边走 Metal worker 单线程串行,跟 CUDA 那种多卡并发是完全不同的工程哲学。Mac 没那么多 GPU 块可以并行,把单 worker 的 throughput 优化到位反而是更现实的路径。
API 也做得很取巧。ds4 的 /v1/messages 端点直接 Anthropic 兼容——你之前用 Claude SDK 写的代码,把 base URL 一改就能跑本地 DeepSeek v4 Flash,不用动业务逻辑。
我看下来感觉是这样:antirez 这次没在卷新模型,他在做一件被严重低估的工程——「把现有最强模型的运行成本压到工程师个人能负担的位置」。这跟 OpenAI 那种「让模型更强」的产品哲学是正交的两条路线。下半年本地 AI 这条线,会越来越多看到这种「砍量化 + 砍 cache + 兼容主流 API」的组合拳。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#antirez #DeepSeek #LocalLLM #Metal #AI工具
原始来源:https://github.com/antirez/ds4
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS