
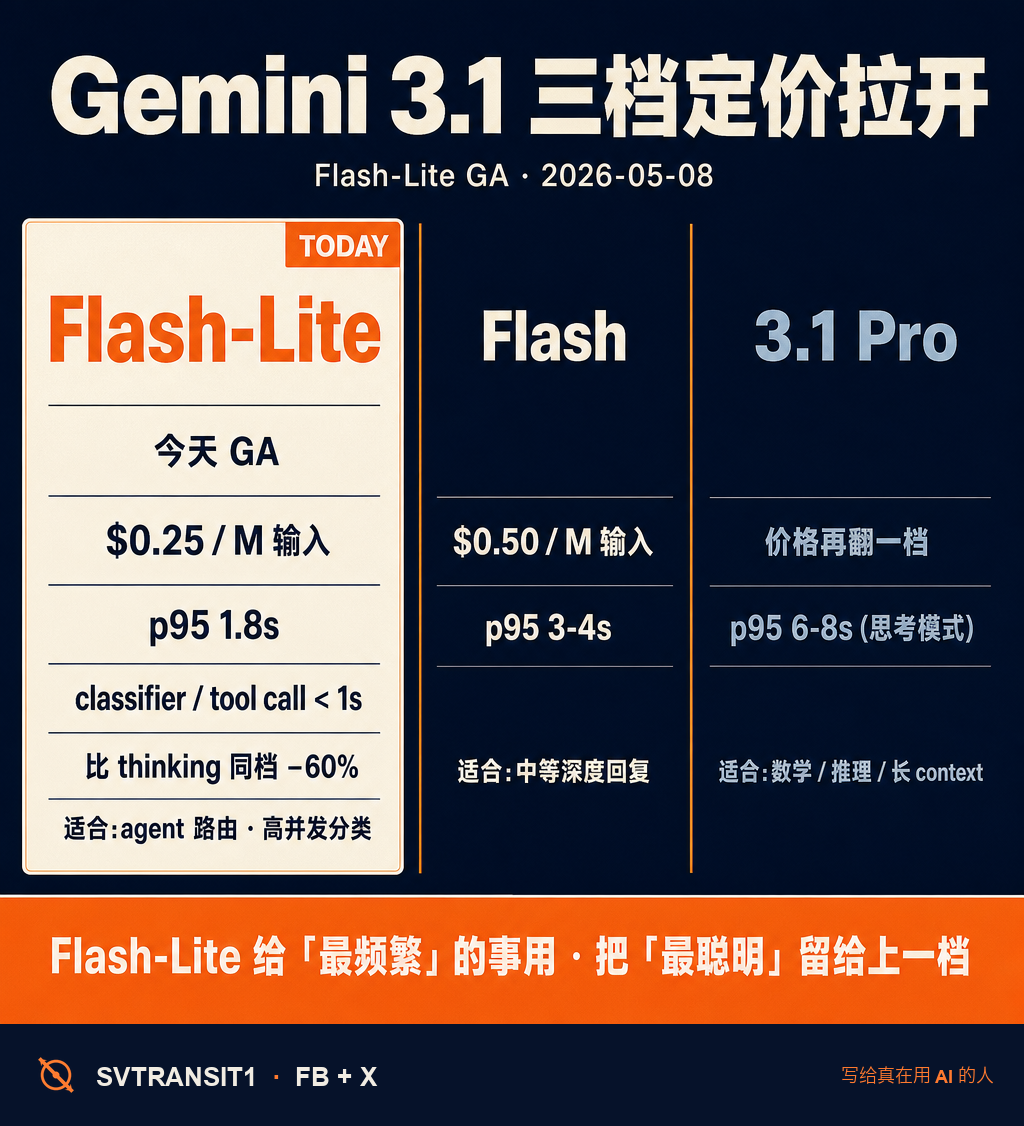
判决先放出来:今天上线 GA 的 Gemini 3.1 Flash-Lite,比同档位 thinking 系列模型便宜 60%,p95 1.8 秒出完整回复,classifier 跟 tool call 跑进 1 秒以内。
谁该用、谁不该用,可以从三条具体的轴拆开看。
价格轴。Flash-Lite 输入 $0.25 / 百万 token,Flash 同条件 $0.50,3.1 Pro 价格再翻一档。Flash-Lite 跟 Flash 之间的差距没法用「省一点」概括——直接砍半。这个砍半,在 agent 场景里——一次请求要触发几十次模型调用——会被乘成 30-50 倍的成本差距。
延迟轴。Flash-Lite p95 1.8 秒;Flash 可观测的 p95 在 3-4 秒区间;3.1 Pro 思考模式可以跑到 6-8 秒。延迟敏感的应用——客服对话、实时翻译、agent 工具路由——p95 1.8 秒是个分水岭。在它上面,用户感知是「等」;在它下面,感知是「立刻」。
任务轴。Google 官方推荐 Flash-Lite 跑这几类:超低延迟分类、tool calling、agent 编排、高并发批量任务。它没推荐它跑长上下文推理,也没推荐跑代码生成主线工作。这条线的产品定位很清楚——它给「最频繁」的事用,把「最聪明」留给上一档。
谁该选哪个?如果你在做 agent 的路由层、做内容审核分类、做 transcript 实时转写——Flash-Lite。如果你在做客服一次性的复杂回答、做 spec 推导——Flash 起步。如果你需要数学、推理、长 context——3.1 Pro 或者 Anthropic Opus。
下半年看到的趋势:中型模型这条线在被迅速分层。3.1 Pro 抓深度,Flash 抓平衡,Flash-Lite 抓高频低成本。三档定价拉开,产品端选型反而更清楚了。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#Gemini #FlashLite #Google #AI模型 #AI工具
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS