
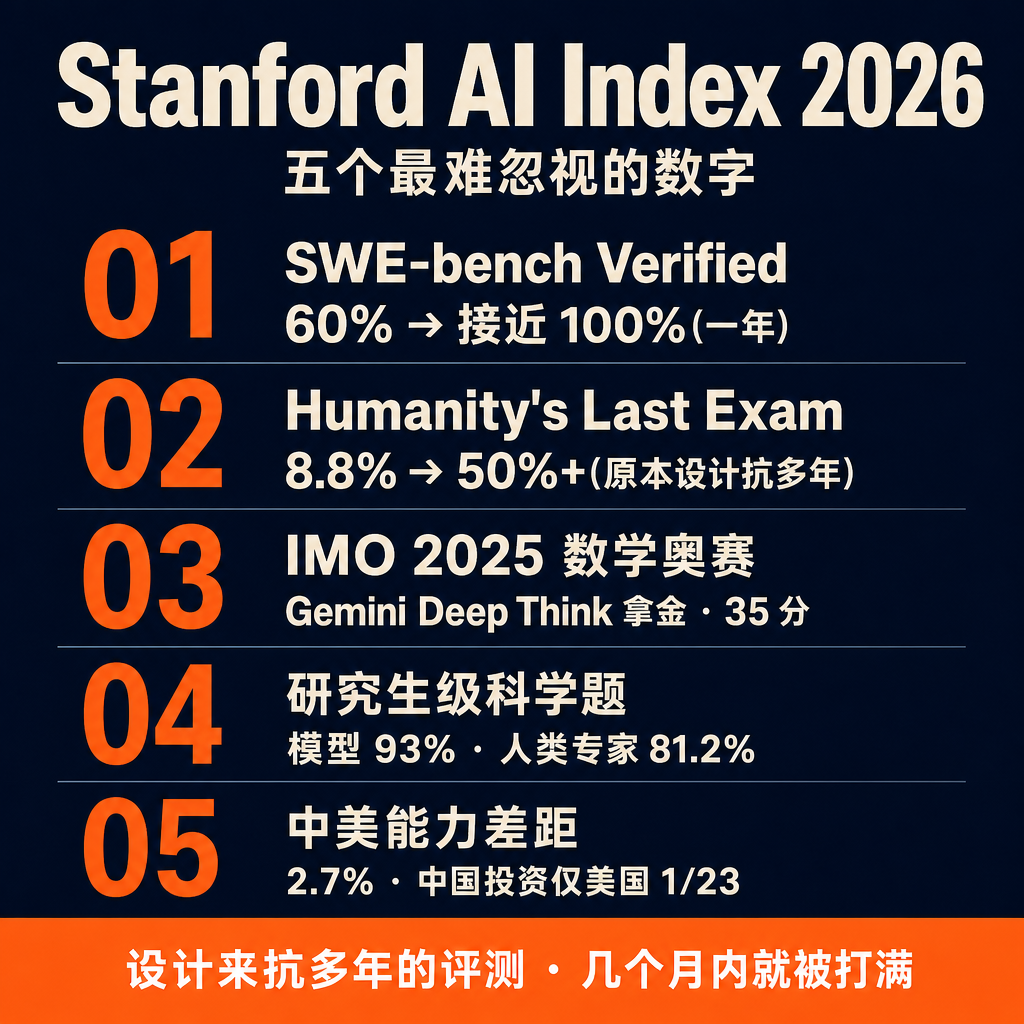
Stanford HAI 第九版 AI Index 这周完整发出来了。我把里面五个最难忽视的数字拎出来,每一个都在重新定义「AI 能力到底走到哪里」的对话。
-
SWE-bench Verified:60% → 接近 100%
一年时间。这个 benchmark 设计目的是测真实软件工程任务,过去公认是反映 coding agent 上限的硬指标。一年从 60 到 100,意思是这条曲线已经触顶,新模型必须找新 benchmark 比。
-
Humanity’s Last Exam:8.8% → 50% 以上
去年这个考试推出时,OpenAI o1 拿到 8.8% 是当时榜首。设计目标是「让 AI 长期跑不过人类专家」。结果到 2026 年 4 月,Claude Opus 4.6 和 Gemini 3.1 Pro 双双过 50%。Stanford 用一句话总结:「设计来抗多年的评测,几个月内就被打满。」
-
IMO 2025:Gemini Deep Think 拿 35 分金牌
去年 IMO 2024 同一个模型线只拿 28 分银牌。2025 年用自然语言,在 4.5 小时考试时间内端到端跑完,直接金。Stanford 在报告里强调,这是 AI 第一次按真人选手规则参赛拿到金。
-
研究生级科学题:模型准确率 93%
人类专家校验员的基准是 81.2%。模型已经显著超过验证人类专家在自己领域的表现。这个数字在生命科学、化学、物理领域都成立。
-
中美差距:2.7%,但中国投资是美国的 1/23
2025 年中美顶级模型性能差距还在 17%,2026 年缩到 2.7%。同期中国 AI 总投资是美国的 1/23。Stanford 的解读是:工程效率,正在变成新的护城河。
我看下来感觉是这样:2026 年讨论 AI 进展,引用「benchmark 分数」的边际效用在快速塌陷。能力跑得比 benchmark 设计速度快。下半年真正重要的提问已经从「我家模型 SWE-bench 几分」转到「我家模型在你的真实业务流里跑得通」——这正是上周 ClawBench 那种真生产环境评测开始重要的原因。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#StanfordAIIndex #AIBenchmark #AI能力 #AI进展 #AI报告
原始来源:https://hai.stanford.edu/ai-index/2026-ai-index-report
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS