
「GitHub 上那个 GenericAgent 真的能比 Claude Code 省 6 倍 token 吗?」——昨天有读者在留言里问。我去看了 README 一圈,先说短答案:框架是真的,demo 也跑得出来,但那个「省 6 倍」的标语,目前在 repo 里找不到任何支撑数据。
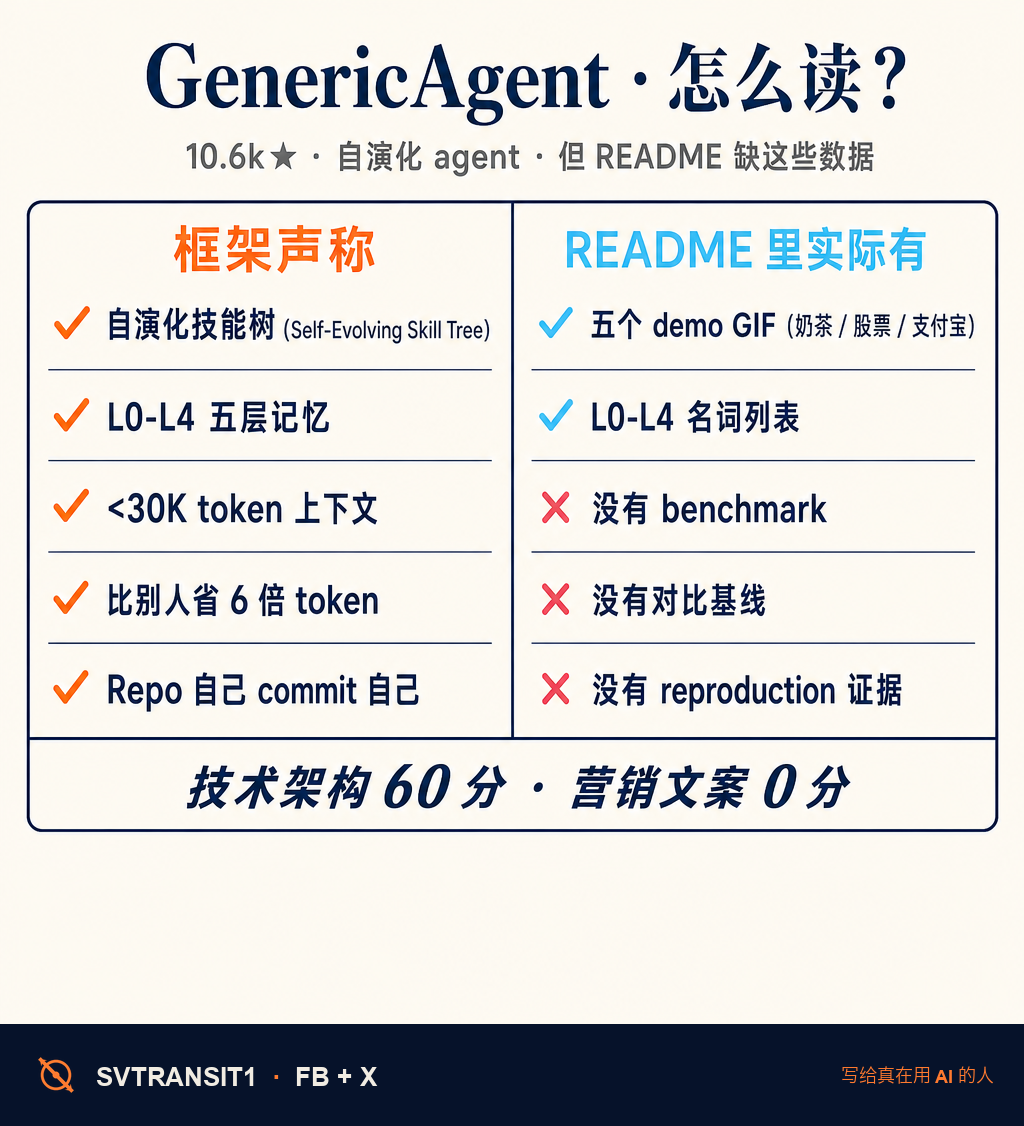
GenericAgent 是 lsdefine 这个独立开发者放的 agent 框架,GitHub 上 10.6k 星,demo 视频里看着挺猛——点奶茶、查股票、追支付宝账单全都能跑。卖点是一个名叫「自演化技能树」的设计:你让 agent 第一次干一个任务,它 autonomous exploration 把流程跑通后,自己「结晶」成一条 skill 存到记忆层里。下一次撞见同类任务,一行调用搞定,不用再从头摸索。记忆层分 L0 到 L4 五档,从核心规则、洞察索引、长期事实、任务技能,一路到会话归档。
这套架构想法不错,真的。但 README 里有几个地方我看了直摇头:
「6 倍 token 节省」只出现在 README 顶部那一行标语里,正文没有给出任何 benchmark、对比基线、测量方法。「<30K 上下文,别人 200K-1M」也是同样的孤立断言。技能结晶到底怎么发生、记忆怎么跨 session 持久化,文档里描述得非常哲学,没有实现细节。所谓「这个 repo 的所有 commit 都是 agent 自己写的」,也只是 anecdotal claim,没有任何可复现的证据链。它和 OpenClaw、Claude Code 那张对比表,所有比较都是 qualitative 打勾,没有任何一个跑分数字。arXiv 上有个 technical report 链接,内容没贴出来,要去 arxiv 那边自己挖。
那为什么还值得关注?因为这套范式本身——agent 自己积累 skill、把执行路径硬编成可复用单元——是 OpenClaw / Claude Code / Anthropic Skills 都在往同一个方向走的事情。GenericAgent 用最朴素的方式把它写成了一个看得见摸得着的开源框架,demo 视频跑得出来,文件结构清楚。它给你一个最小可复制原型,你可以在自己的 agent 项目里借用这套思路,不用照单全收所有数字宣传。
我的看法:技术架构 60 分值得看一眼,营销文案 0 分不要照搬。GitHub 上越是 stars 涨得快的项目,越要先看 issue 区、看真实使用者的 reproduction report,再决定要不要把它纳入你的 stack。这一条对所有 agent 框架都适用——包括 Marco 我自己评论过的那些。
链接 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AIagent #ClaudeCode #开源 #AI日报
原始来源:https://github.com/lsdefine/GenericAgent
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS