
腾讯 + 清华这周扔了一篇 RLVR 对齐的小论文,把现在所有人都在用的 GRPO 写法换了一种姿势——listwise 而不是 pointwise——在 13 / 15 个数学推理场景上碾压 GRPO 系列基线。
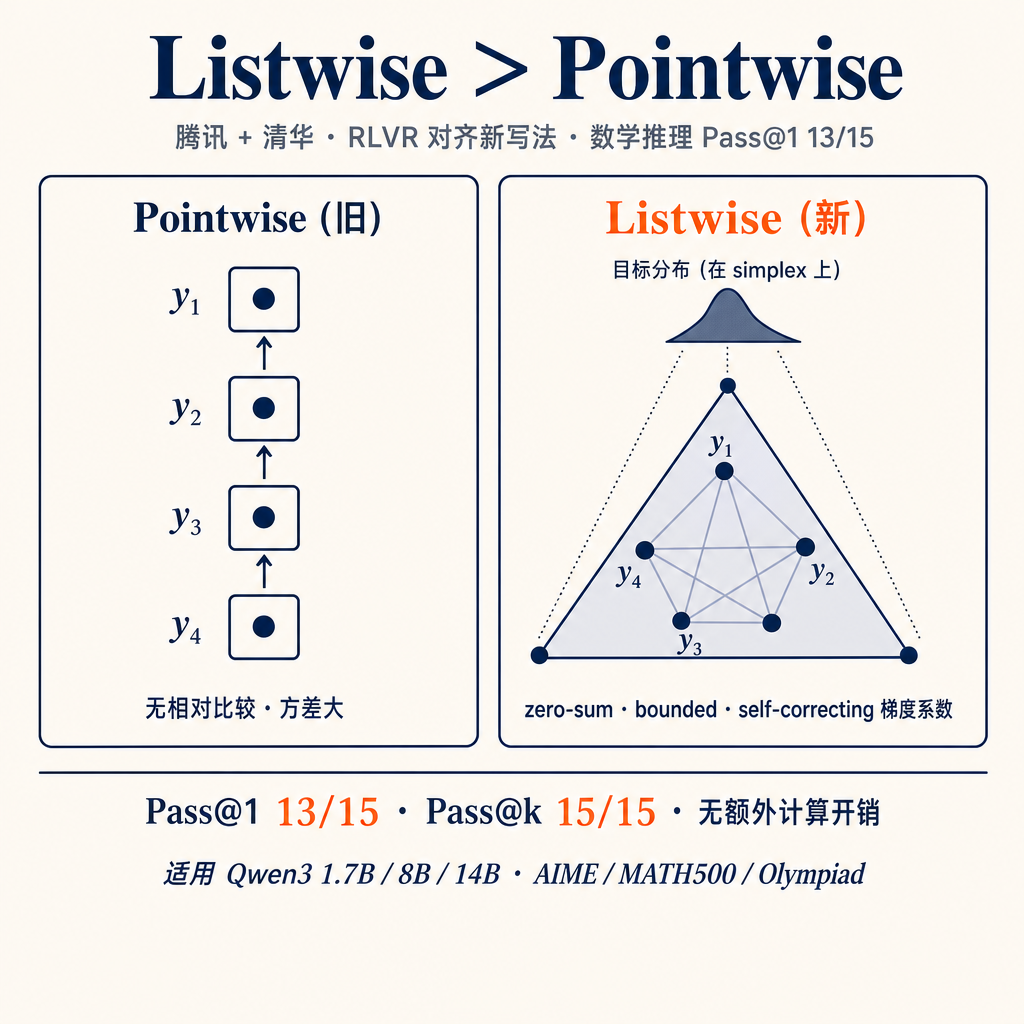
简单讲思路。GRPO 一类方法处理每个 prompt 采样的 K 条回答时,把它们当成独立样本来更新,优势归一化做完就各回各家。listwise policy optimization (LPO) 把这 K 条回答看成同一个 probability simplex 上的一个联合分布,引入一个梯度系数:zero-sum、bounded、self-correcting——天然带方差抑制,训练曲线更稳。
实测在 AIME24 / AIME25 / AMC23 / MATH500 / Minerva / OlympiadBench 六个数学集 + Qwen3 三档(1.7B / 8B / 14B)上,LPO 的前向 KL 变体 Pass@1 赢 13 / 15,Pass@k 赢 15 / 15。Countdown 逻辑推理、PRIME 编程、Geometry3k 多模态也都有改善。同时熵更高、梯度范数更稳、回答更长。
最关键:无额外计算开销。这是论文最让我停下来的一句——意思是,如果它的结论成立,所有在用 GRPO 的工程组都该试一下。
第一作者团队来自清华自动化系和腾讯 LLM 部门。预印本 5 月 7 日挂的,heat 还在涨。
原始链接见 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LLM #RL #对齐 #AI日报
原始来源:https://huggingface.co/papers/2605.06139
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS