
Nathan Lambert(interconnects.ai 那个写 RLHF 写到出名的人)这周飞了一趟北京,36 小时里跑了 Z.ai、Moonshot、清华、美团、小米、01.ai、阿里、ByteDance、DeepSeek、Qwen、Ant Group、华为这一圈,回去写了一篇"中国 AI 实验室内部观察"。值得读,因为这是少见的西方研究者直接进屋看了一遍写出来的东西。
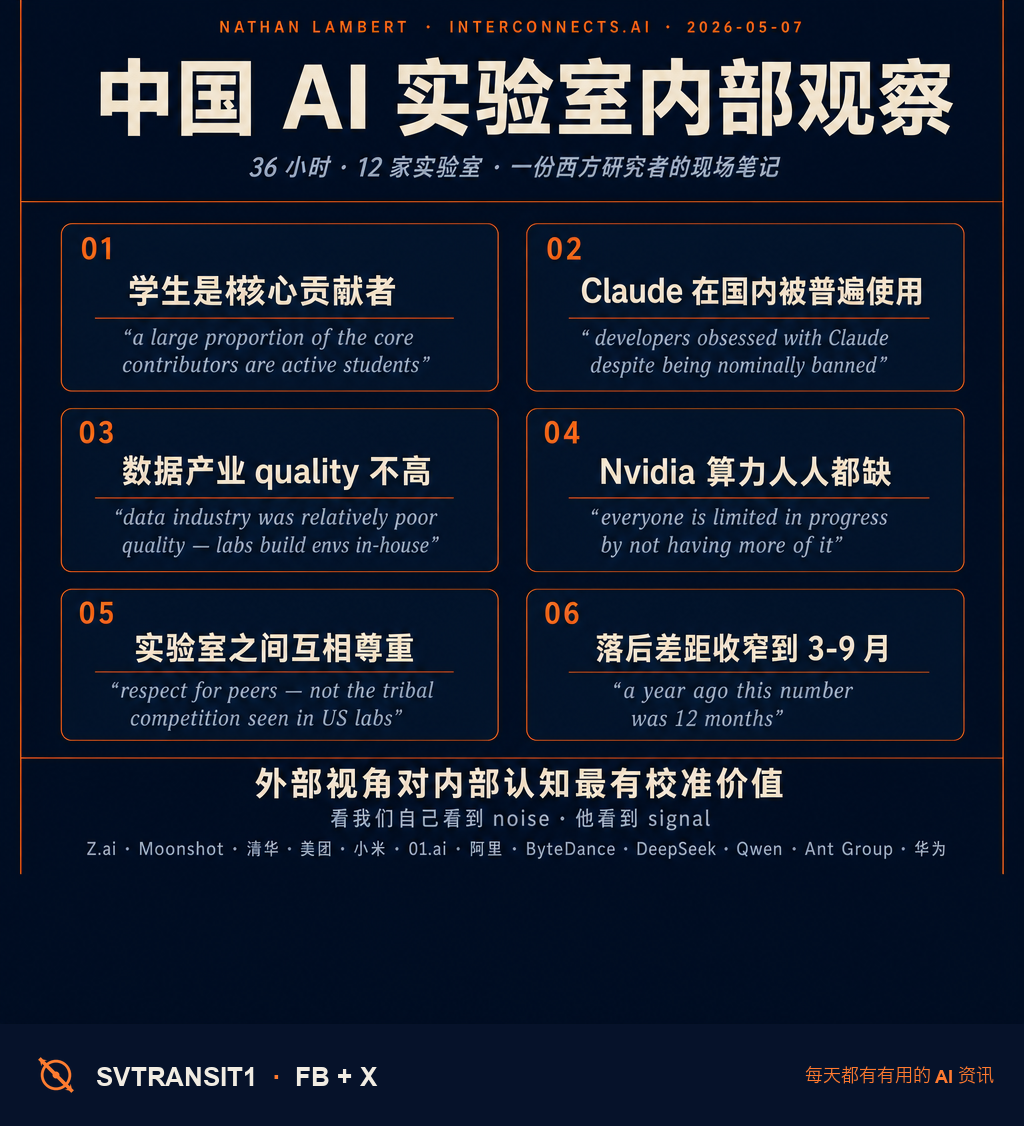
他的几个观察很扎实。
一是学生比例。他写”a large proportion of the core contributors are active students”——核心贡献者里相当大一部分是在读学生,而 OpenAI、Anthropic 这种美国实验室”simply don’t offer internships”。学生研究员愿意做不光鲜的脏活,模型最终质量就赢在这。
二是 Claude。他原话:”Most of the AI developers in China are obsessed with Claude… despite Claude nominally being banned in China.” 他遇到的几乎每一个开发者都说自己在用 Claude 写代码,哪怕同一个人在演示时切换到 Kimi 或 GLM 的 CLI。这件事西方人是头一次写下来。
三是数据。他形容 China 的数据产业 “relatively poor quality”,所以各家被迫在自己实验室内部搭训练环境——Anthropic、OpenAI 单一个 env 花 1000 万美元买的事,这边花不起,只能自己造。
四是文化对比。他说中国各家是 “respect for peers”,不像美国实验室那种”tribal”互相敌对。当然这是外部观察,内部可能没那么和睦。
五是芯片。所有人都缺 Nvidia——这件事不分国别,全球研究员都在排队。
他给出一个不太讨好的数字:中国前沿模型整体落后美国前沿”3-9 months”。这个区间在过去一年压缩很快——一年前同样的人会说 12 个月。
我觉得这篇值得我们自己读一遍的原因是:外部视角对内部认知最有校准价值。我们看自己的实验室容易看到 noise,他看一眼看到的是 signal。
转给那个还在以为 Claude 在国内”没人用”的同事。
关注 @svtransit1 · 写给真在用 AI 的人
来源 · 评论区取 ↓
#AI #LLM #DeepSeek #Qwen
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS