
如果你是一个应用层创业者,2026 这一年关于"我们要不要自己训模型"的争论应该终结一下了。Latent Space 上 swyx 这一期把 application-layer 公司接下来三年的演化路径压成了一个三步走,叫 "Agent Labs Thesis",挺值得读。
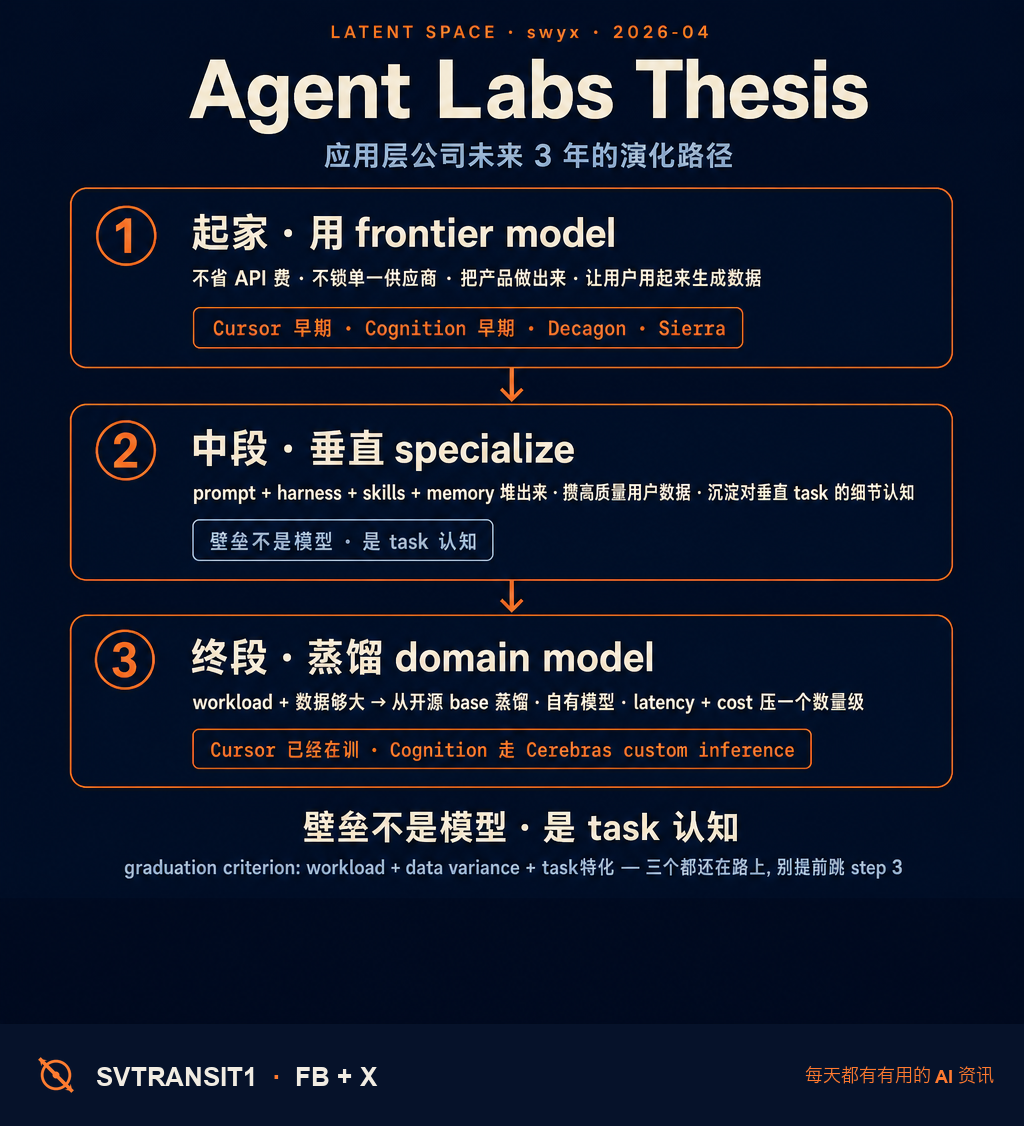
第一步:用最强的 frontier model 起家。先别想着省 API 费用,也别想着哪天 OpenAI 倒闭你怎么办——你这阶段唯一的任务是给用户做出一个真正解决问题的产品,把数据生成出来。Cursor、Cognition、Decagon、Sierra 这一批 2024-25 起家的公司全是这条路。
第二步:在你这个垂直领域 specialize。frontier model 解决 80% 的通用能力,但你的产品有特定的 task 结构(编程的 diff、客服的对话历史、CRM 的字段映射),这些都要靠 prompt engineering + harness + skills + memory 一层层叠出来。这一阶段你积累的是两样东西:高质量的用户数据,和对你这个垂直 task 的细节认知——后者才是壁垒,不是模型本身。
第三步——也是 swyx 这一期最有意思的部分——等到你的 workload 够大、数据够好、task 的 variance 够清楚,就可以训自己的模型了。不是 from-scratch 训,是从开源 base model 出发蒸馏一个 domain-specialized 版本。Cursor 已经在训自己的;Cognition 走的是 Cerebras custom inference 路线。这一步的 ROI 不是”我们也能做大模型”,是 latency 和 cost 在你这条业务线上能压一个数量级。
swyx 里有一句话我觉得 Chinese 创业者听了应该有共鸣:skills 的最小可行形式就是”一个 markdown 文件加几个 script”——没了。看到 Anthropic 上周 ship 的 Agent Skills 用的就是这个格式时,他直接说 “I don’t see how it can be more simple than that.”。意思是 agent 的能力打包方式不应该是另一个 framework、另一个 SDK,就是 plain text + 可执行代码。
落到中文社区的应用层公司——你现在做选择的依据应该是这三步里的 graduation criterion:你的 workload 够不够大?你的数据够不够清晰?你的 task 够不够特化?如果三个都还在路上,那就老老实实在 step 1 + step 2 之间深耕。不要被”国产化”或者”自研”的叙事推着提早进入 step 3——那是烧钱跑得最快的方式。
转给那个还在纠结”现在自己训模型来得及吗”的朋友。
关注 @svtransit1 · 写给真在用 AI 的人
链接 · 👇 第一条评论
#AI #LLM #创业 #Cursor
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS