
你的 agent 每天都从零开始——这个开源库给它装了个 95.2% 召回率的记忆。
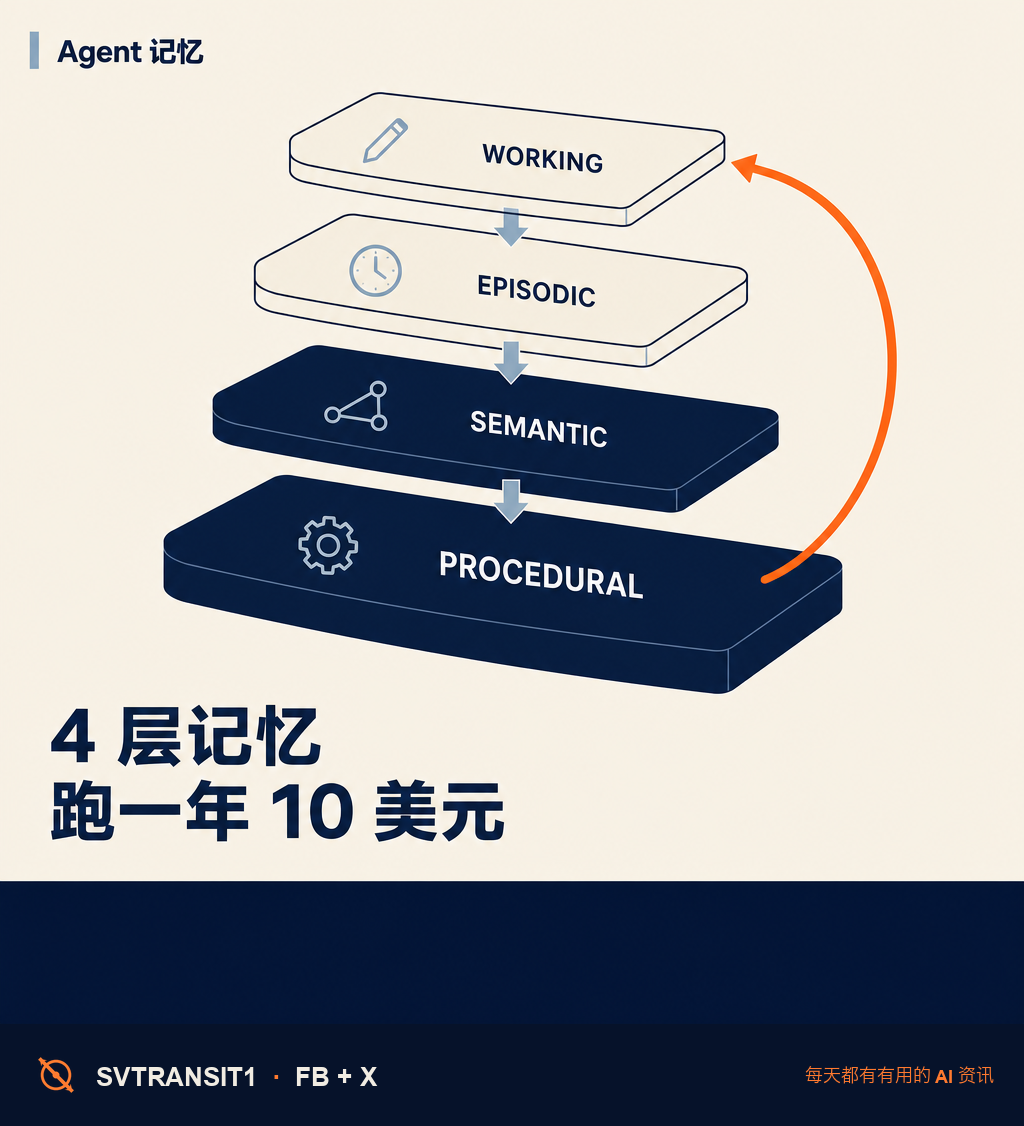
GitHub trending 上 12 小时蹿了 1000 颗星的项目,叫 agentmemory,目标是让 Claude Code、Cursor、Gemini CLI 这类 coding agent 跨 session 记住事情。它把 5 件事一起做了。
① 记忆分 4 层,照人脑睡眠时的整理机制来:working → episodic → semantic → procedural。每层存储格式和淘汰速度都不同。新东西先进 working,反复用到的下沉到 semantic 和 procedural。一周后还在被引用的内容就稳定下来,只用了一次的就会被淘汰。这一套不是 vector DB 厂商那种”全存下来”的暴力路线。
② 检索是 BM25、向量、知识图三路并行,用 Reciprocal Rank Fusion 合分。LongMemEval-S 这个 500 题召回基准上,recall@5 拿到 95.2%——光跑 BM25 只有 86.2%,差的就是这层混合。
③ 一年大概 17 万 token、10 美元——跟”让大模型每次写一遍摘要”的方案比,后者要烧 65 万 token,大概 500 美元。一个数量级的差。
④ 12 个自动捕捉钩子。Agent 干活时透明记录,你不用手动 push 任何内容进去。改一次配置、跑一次失败的测试、回滚一次 commit——这些瞬间都会被分类归档,不需要你回头总结。
⑤ 自带秘密剥离。写进 memory store 之前会过一遍,API key、密码这些不会留痕。
本地跑、自托管,不依赖外部数据库。接入路径走 MCP 或 REST,目前已经覆盖了 Claude Code、Cursor、Gemini CLI、Cline 加另外 10 多个。
context bleeding 这个痛点大家都在抱怨——前一天跟 agent 约定好的命名规范,今天它又给你换了个写法;上周聊过的项目背景,这周得从头再讲一遍。每次重新讲都是 token 费,也是注意力损耗。
这个库不一定就是终局方案,但它把”持久记忆该多便宜、多准”这两件事先按下来了——10 块钱跑一年,recall@5 拿到 95.2%。后面再有新的方案出来,这就是参考线。
关注 @svtransit1 · 写给真在用 AI 的人
完整链接 · 评论区取 ↓
#AI #ClaudeCode #AIagent #开源工具
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS