
DeepSeek 训练只花 600 万美元——这个段子之所以错,是因为搞混了一件事:研究成本,和最终训练成本。
Nathan Lambert 这周写了一篇分析,叫《How Open Model Ecosystems Compound》。他想回答一个 Chinese AI 圈天天在讨论的问题:为什么中国实验室在开源这件事上跑得这么快,而美国闭源那边对此越来越紧张。他给的不是政治答案,是技术答案。
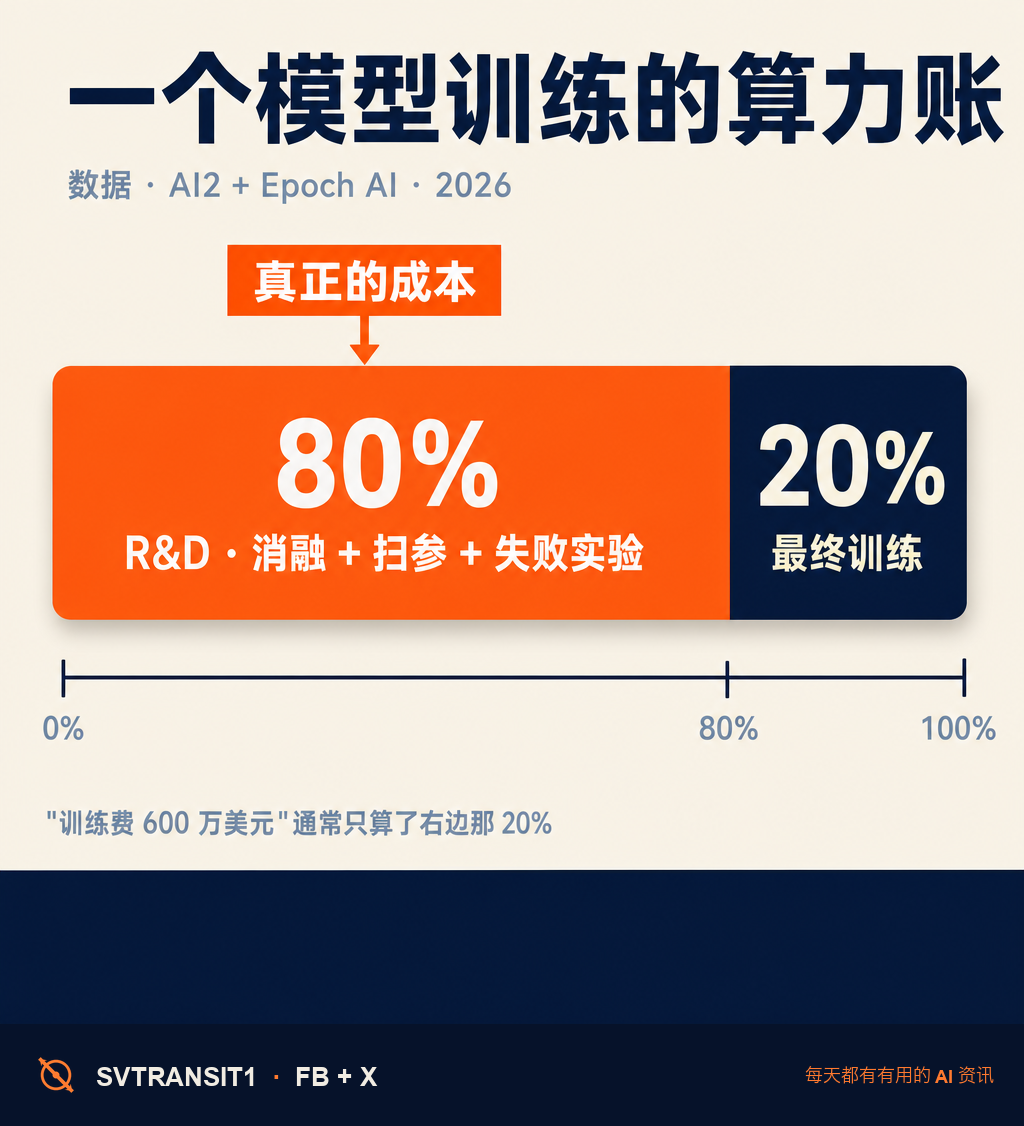
先把”训练成本”拆开。引用 AI2 和 Epoch AI 的数据——一个前沿模型最终落地之前,大约 80% 的算力是花在 R&D 上的:消融实验、超参数扫描、数据配方、失败的架构尝试。真正”按下训练按钮”那一次只占 20%。所以”DeepSeek 训练花了 600 万美元”那个数字,严格说是最后一次跑的硬件费,不是 R&D 的总开销。把那 80% 算回去,数字要翻好几倍。
但 Lambert 真正押的点在下一步:中国实验室通过那些被国外评论员吐槽”过于详细”的技术报告——DeepSeek-V3 的 paper 是典型——实际上是在替同行预先做掉那 80% 里的一大块。Qwen 团队跑过的 ablation,Kimi 看了不用再跑;Moonshot 失败的 router 配置,DeepSeek 一眼就跳过;某家把 MoE 的 expert balancing 算法写清楚了,后面所有人省下两个月。这是真正的”复利”:别人花掉的钱,变成你的免费起点。
举个具体的:DeepSeek-V3 那篇报告里写了 MLA 注意力机制怎么把 KV cache 砍掉一个数量级、auxiliary-loss-free 的负载均衡怎么设计、FP8 训练里 numerical stability 怎么稳住。每一条都是别人砸钱试错出来的结论。后面 Kimi K2、Qwen3、Moonshot 各自的新版,可以站在这些结论上做差异化创新,而不是从零开始把同一道墙再撞一遍。这套机制美国闭源那边复制不来——OpenAI 不会公开自己怎么解决 MoE 路由抖动的,Anthropic 不会告诉你 RL 训练里哪种 reward shaping 翻车了。
这跟传统软件开源很不一样。Linux 内核被 fork 不会让 Linus 下个版本省力——传统 open source 没有”创作者降本”的回路。但 AI 模型有,因为大头开销是 R&D 不是分发,而 R&D 的产物——结论、消融、什么不 work——是知识形态,可以跨实验室传染。
闭源那边没有这个回路。OpenAI 内部的 ablation 不会出门,Anthropic 的失败实验也不会公开。他们的”规模经济”靠的是用户数、单次推理摊薄、云上的边际成本下降。这套在闭源生态里成立,但跟开源是两条完全不重叠的曲线。这也是为什么 Lambert 判断未来不会”收敛到一个 base model”——竞争优势在你怎么把 hardware、data、infra 整合起来,不在”谁的模型权重最好”。模型只是节点。
文章里有个比较冷的观察值得专门拎出来:很多企业把”开源”工具 fork 进内网当闭源用,这种 fork 不再回馈生态——名义上是开源参与者,实际上在抽走价值。开源的复利效应需要参与者真的把研究产物吐回去,光下载不算。这一点对中国大厂尤其要警惕:Llama 时代有过这种”白嫖+内部魔改”的盛况,但那是一次性套利,不是生态。Qwen 现在做对的事情是把权重和报告同时放出来,让自己也成为生态的一部分。
还有一个尚未解决的口子:大规模 RL on MoE 的真正”开源 recipe”目前还不存在。Qwen、DeepSeek、Kimi 各自的技术报告写得很细,但拼起来还不是一个可以直接复刻的 pipeline。这个空白哪天被填上,中国开源生态的复利会再上一个台阶。
老实说,Lambert 给的这个框架对刚开始关注开源 AI 的人挺有用——它把”中国开源跑得快”从一个直觉,翻译成一个可以验证的机制。不是”我们厉害”,是”我们这套结构里,降本能传染”。
下回再看到”DeepSeek 训练才 600 万美元”这种话,记得后面那 80%。真正的故事不在那次最后训练上,而在过去两年里几十家中国实验室互相帮对方降这 80%——这才是中美开源速度差的技术解释。
关注 @svtransit1 · 写给真在用 AI 的人
原始出处 · 第一条评论拿 ↓
#AI #开源模型 #DeepSeek #Qwen #Interconnects
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS