
你部署 LLM 应用为什么觉得别扭——过去 20 年的 web 架构,三个核心假设它一个都不满足。
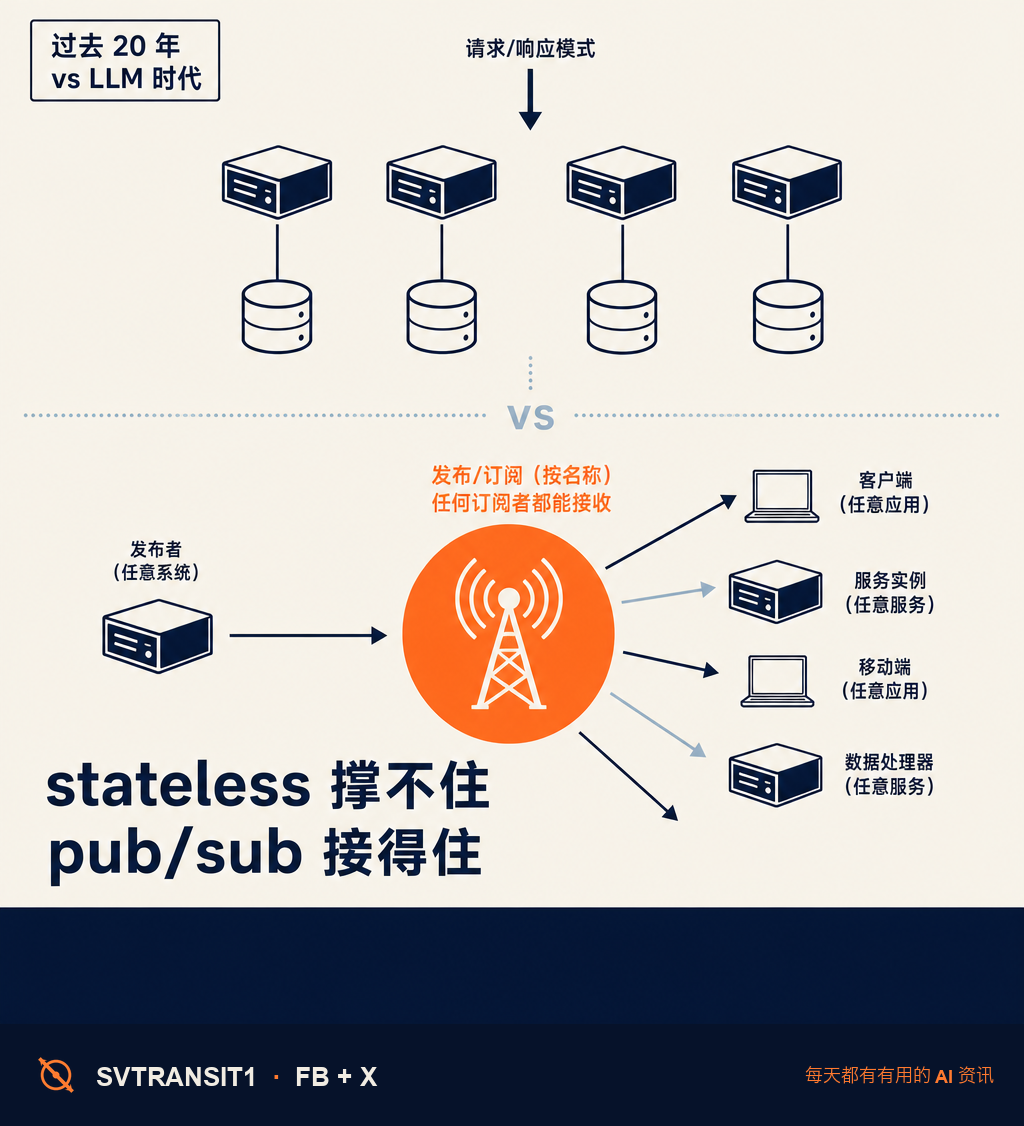
Zak Knill 这周写了一篇分析,叫《LLMs Are Breaking 20-Year-Old System Design》。他不是在说 LLM 本身有问题,是在说我们用来部署它的脚手架——stateless 工人池、HTTP request/response、数据库当状态唯一来源——这套从 2005 年左右成熟的 web 架构,撑不住 LLM 应用的形态。
哪三个假设崩了。一个是”任务都很短”——HTTP 一来一回几百毫秒到几秒,服务器干完就忘。LLM 单次推理几十秒,带工具调用的 agent 跑十几分钟很正常,这是 long-running。另一个是”状态在数据库”——服务器进程当无状态工人,状态丢回 DB 再读出来。但 LLM 的”状态”是几万 token 的 context,每次重读延迟和成本都上一个台阶,这是 stateful compute。还有一个是”交互是单向的”——客户端发请求、服务器回结果,完事。LLM agent 不是这样:用户要边看边干预,模型边干活边问”要不要这样”,这是 bi-directional interaction。
现在 dev 们的临时方案都是绕。长任务用 polling——Knill 那句”polling treats your database as a message bus, which is what folks did before actual message buses existed”挺狠:大家在用现代数据库扮演消息总线,是真消息总线出现之前的老办法。双向交互用 WebSocket,但 WebSocket 是 「a connection, not an address」——一旦断开,你再也连不回原来那个跑着 agent 的进程,只能从头再来。状态推回数据库,每次 LLM 调用拿 context 都要再读一遍。这些都不是”答案”,是”凑合”。
Knill 的核心论点:真正缺的是一个 routing primitive——按名字寻址的 pub/sub channel。客户端和服务器都按 channel 名字订阅(比如 chat-session-abc123),不在乎背后是哪个具体进程在跑。某个进程死了重启,新进程订阅同一个 channel,客户端无感重连。这跟 actor model 不一样:actor 是按 handle 找具体实体,pub/sub-by-name 更像 ham radio 频道——谁站在那个频道上谁就收得到,发送者不关心是谁。
为什么这件事 LLM 时代变得重要。Knill 给了一个关键 insight:LLM 响应「is not deterministic, and is not cheap」——传统 stateless retry 模型默认重跑没成本、结果一样,所以连接掉了再来一次。但 LLM 重跑既贵又不可重现,你必须在原来的状态里接着走,不能从头来过。这也是为什么把 LLM 应用塞进 12-factor 那套规范总觉得不舒服:12-factor 是为 stateless workload 写的合同,而 LLM 的工作负载本质不 stateless。
未来 5 年的预测。Knill 押的方向是:agent framework 那波(LangChain、LangGraph 这类编排层)是过去 3 年的热闹,但它们都建在过时的 stateless 底座上。下一波基础设施重塑,是底座这一层:pub/sub channel 当 routing primitive,长任务、状态、双向交互一起成为一级 abstraction,而不是用 polling 和 WebSocket 凑出来的二等公民。
老实说,任何写过 agent 后端的人对这个判断都会点头。你试着把 Claude Code 风格的工具搬到 production,第一个撞的不是模型质量,是基础设施。Knill 没把答案完全推到底,但他把”问题在哪里”指清楚了,这种 meta-engineering 的 thesis 比又一个 framework release 有用得多。
关注 @svtransit1 · 写给真在用 AI 的人
原文链接放在第一条评论 ↓
#AI #LLM #系统架构 #PubSub #Infrastructure
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS