
99M 参数的 TTS 模型,在 Raspberry Pi 上跑出 0.3× real-time,Supertone 这周把整套开源了。
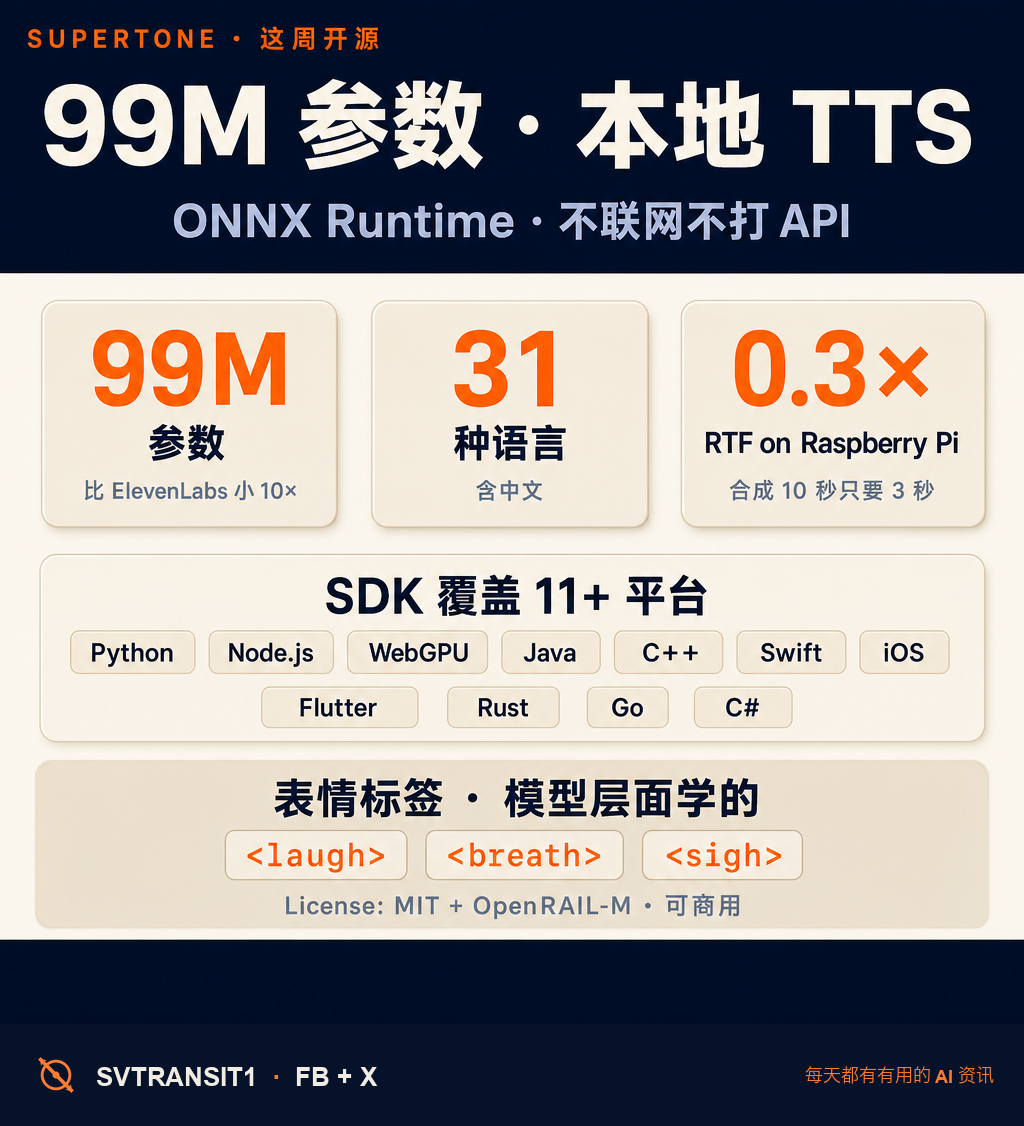
GitHub 上叫 supertonic,来自做声音 AI 的 Supertone Inc。整套基于 ONNX Runtime,完全本地推理,不联网、不打 API。这个项目把哪几件事一起做了:
① 模型小到能塞进手机。99M 参数——对比 OpenAI TTS / Gemini Audio / ElevenLabs 那些 0.7B 到 2B 的尺寸,小一个数量级。但官方说在多语言文本处理上反而比这些大模型稳。
② Raspberry Pi 上 0.3× RTF。意思是合成 10 秒音频只要 3 秒——一个手掌大小的设备能跑出超实时速度。在普通 CPU 上跟用 GPU 跑大模型基线 comparable。延迟跟成本一起按到地板。
③ 31 种语言一个模型。英、西、法、德、日、韩、俄、阿拉伯、越南,加另外 22 种。中文也在里面。语言切换不用换 checkpoint,模型自己识别。
④ SDK 覆盖到离谱的程度。Python、Node.js、浏览器(WebGPU + WASM)、Java、C++、C#、Go、Swift、iOS、Rust、Flutter——11 种以上。基本上你能想到的客户端栈都有。
⑤ 输出还支持表情标签。在文本里塞 「laugh」、「breath」、「sigh」这种 token,合成的语音会真的笑、喘气、叹气。不是后期混音粘上去的,是模型层面学的。
⑥ License 务实。Sample 代码 MIT,模型权重 OpenRAIL-M——可以商用,有责任条款约束。不是”开源给你看 demo,真用要付钱”的套路。
意义在哪。过去一年 TTS 圈子的话题都是”哪家云端 API 更像人声”。Supertonic 这波是从相反方向打:把模型砍小、推理放本地、覆盖语言堆到 31 种、SDK 撒到所有平台。换句话说,它把 TTS 从”按调用付费”重新拽回”内置在你应用里的能力”这一档。
对开发者影响最直接:做 AI 客服、智能家居语音、辅助阅读、视频自动旁白——以前要考虑”每条音频 X 分钱”,现在变成”塞个模型进 app 就行”。云端 TTS 厂商接下来的日子要重新算账。
关注 @svtransit1 · 写给真在用 AI 的人
原始出处 · 第一条评论拿 ↓
#AI #TTS #开源工具 #Supertonic #本地AI
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS