
人体动画跑过 15 秒就崩——这条"画质悬崖"现在被一篇新论文搬走了。
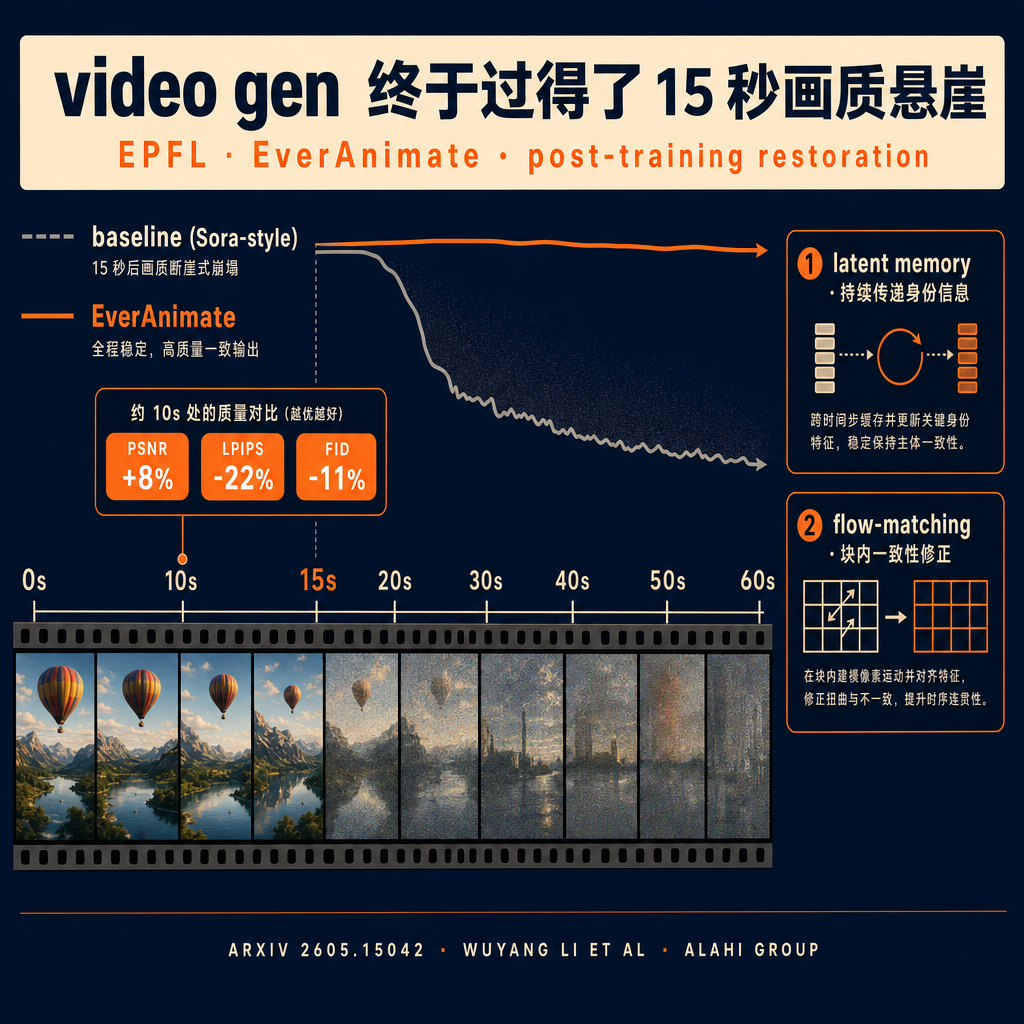
video-gen 圈一直有个公开的秘密:无论 Sora、Pika、还是 OpenSora,只要一个连续镜头跑过 15 到 20 秒,人物的脸开始漂、衣服开始变、背景开始莫名其妙地”换装”。10 秒以内的片段大家都做得挺好,过了就跌进质量悬崖。剪辑师们的对策一直是切镜头切回来——但这只是绕过问题,不是解决问题。
EPFL 的 Alexandre Alahi 组(VITA Lab)这周挂出来 EverAnimate——专门治这个 60 秒+ 的长镜头崩塌问题。作者:Wuyang Li 等。论文标题朴实:”Minute-Scale Human Animation via Latent Flow Restoration”。
技术路线很有意思——他们不重新训一个更大的视频模型,而是把它当作一个”已经训好的零件”,在上面套一层后训练修复(post-training restoration)。两套机制叠加:
一是 latent memory 持续传递。每个时序块的潜在表示不是孤立生成的,而是把前一个块的身份信息(衣服花纹、面部结构、光照方向)显式地往后传。结果是模型不再”忘记”角色长什么样。
二是 flow-matching 做块内一致性修正。每个新块生成后,用 flow 把它和前一块的边界对齐——既消化掉接缝,也压住”突然换衣服”那种典型的视频生成 artifact。
数字也给得很硬:跑到 10 秒处的对照,PSNR 提升 8%、SSIM 7%、LPIPS 减少 22%、FID 减少 11%。22% 那个 LPIPS 数据特别值得看——LPIPS 衡量感知质量(基于人眼对图像差异的判断,不是逐像素 L2),跌 22% 等于”明显变干净”。PSNR/SSIM 是工程指标、FID 是分布距离,这三个加起来涨,说明改善不是一种 metric 的偏置,是真的”看上去更好”。
我觉得这篇真正的价值不在 8% 那个数字,而在思路:大家在卷”训更大、跑更久”的时候,他们提议”训完之后再加一层修复层”——这是从硬训练范式回归到工程修复范式的一种回潮。这种 path 的好处很现实:不需要重训 backbone,可以套在任何现成的 text-to-video / image-to-video 模型上面,把人物长片段的退化问题当后处理来解决。
更直接的对比是 Sora、Veo、OpenSora 这些路线——它们投入巨量算力去把 base model 推到能稳定 30 秒、60 秒,边际成本极高。EverAnimate 等于在说:这个边际成本不一定要硬扛,你训到 10 秒能稳的模型,加一层 Restoration,理论上就能稳到 60 秒。
代码暂时还没放(arxiv preprint),Alahi 组以往的项目一般两三个月内会有 release。如果开源出来,几个月内 ComfyUI 工作流里大概率会看到一个叫 “EverAnimate Refiner” 之类的节点。
转给那个还在试图把 Sora 的 30 秒生成续到 60 秒、结果脸越长越像别人的朋友。
关注 @svtransit1 · 写给真在用 AI 的人
来源 · 评论区取 ↓
#AI #VideoGen #VideoGeneration #ComfyUI #EPFL
原始来源:https://arxiv.org/abs/2605.15042
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS