
这两年 multi-agent 系统的工程化基本就两条路:运行时路由器一派 vs 编译期一派。这周 arxiv 一篇论文把后者推上了 6.4 倍加速。
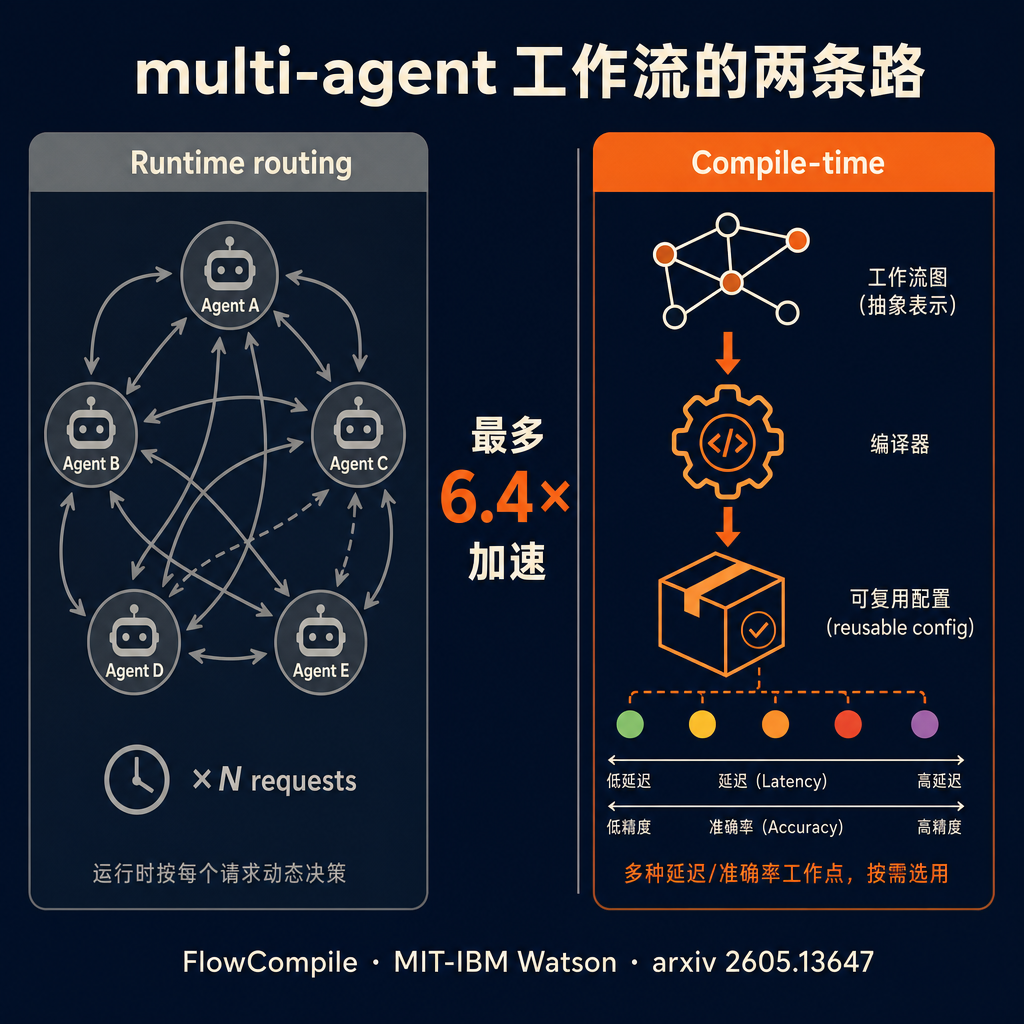
背景说清楚——做 multi-agent 工作流的人,大概率在用 LangGraph、DSPy 或者自己造的 router。共同点是「在每次请求来的时候,动态决定走哪个 agent、用哪个模型、调什么温度」。这是 runtime 调度。优点是灵活,缺点是每次都在重新算同一件事——同一个 customer support pipeline 跑一百万次,routing tree 没怎么变过,但每次都要重新探索一遍设计空间。
MIT-IBM Watson(Chuang Gan 组)挂出来的 FlowCompile 提出的是另一条路:把 multi-agent 工作流当成 TVM 之于神经网络那样的东西。部署前编译一次——把整个 graph 解开,每个子 agent 在不同 setting 下都跑一遍 profile,再用一个 structure-aware 的代理模型把这些测量值组合起来,最后吐出一个”编译过的”配置包。
四条对得起对比的轴:
速度——FlowCompile 报的数字是最多 6.4 倍 vs 手调的 heuristic baseline,精度在大多数 benchmark 上保住。
精度操作点——传统 router 每次跑都在一个点上;FlowCompile 把多个 latency/accuracy 操作点都打包好,部署时按需取用,不用 retrain。
在线开销——传统 router 每个请求都吃一份 routing 决策的延迟和 token;编译派把这部分提到了部署前,运行期纯算 forward。
工程姿态——runtime 派把 agent 当中间件;FlowCompile 把它当编译对象。这才是真正的范式区别。
谁该看?如果你做的 agent pipeline 形状大体稳定、流量大、对延迟敏感——FlowCompile 路线明显更划算。还在实验阶段、每天改 graph 的——继续 runtime 派,别折腾编译。
这不是孤立的信号。前两天 Tencent/清华那篇 listwise policy optimization 也在做类似的事——把 agent 决策从 token-level 提到 list-level;再加上 Anthropic 把 Skills/Managed Agents 做成工程化产物,大方向其实挺一致的:agent 系统从「每次跑都重新拼」的实验性原型,转向「编译一次、复用多次」的工程对象。
代码还没放出来(arxiv preprint 阶段)。但思路最有可能先被 LangGraph、DSPy 那批 framework 抄进去做编译层。半年后,「agent compiler」大概会变成新一代 infra 的标配名词。
转给那个还在手调 LangGraph routing tree 的朋友。
关注 @svtransit1 · 写给真在用 AI 的人
原始出处 · 第一条评论拿
#AI #AIagent #LLM #LangGraph #DSPy
原始来源:https://arxiv.org/abs/2605.13647
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS