
GGUF 文件已经成了"模型分发标准",但里面其实还有四个明显的坑——每个推理引擎都在用 hack 绕。
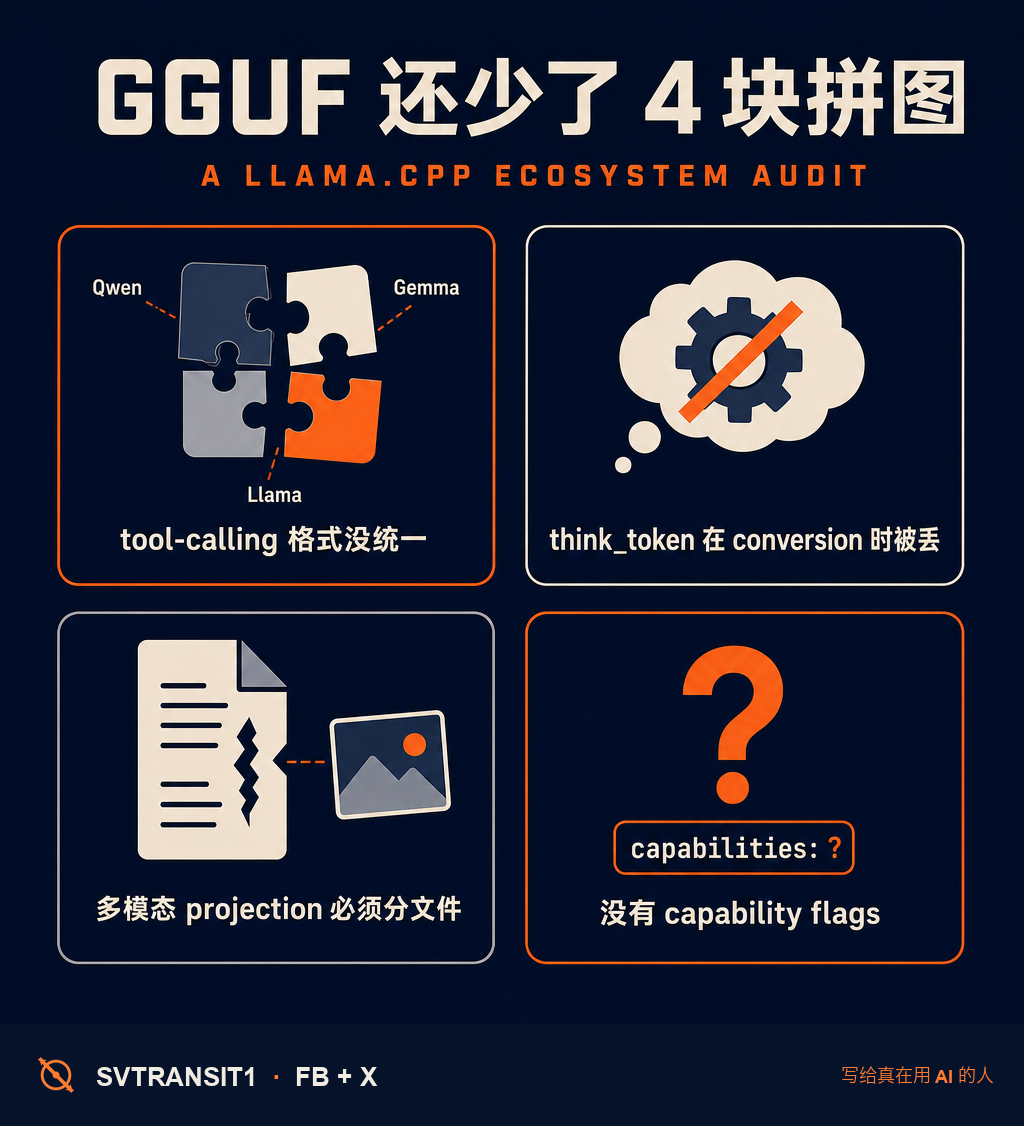
nobodywho.ooo 这两天那篇 “What’s in a GGUF” 把这事拆得很清楚。GGUF 已经塞进了不少东西:Jinja2 chat template、special tokens、sampler 配置、序列顺序。听起来挺完备,但有四个洞还没人补。
1 · tool-calling 格式没标准化
Qwen 一种、Gemma 另一种、Llama 又一种。每个 inference engine 都在代码里硬编码”如果模型是 Qwen,就这么解析”。这种”per-format hack”是 llama.cpp / vLLM / ollama 共同的脏代码源。作者的建议:把 grammar 塞进 GGUF——derive parser 而不是手写。
2 · think_token 在下游被丢了
上游 HuggingFace 的 tokenizer config 已经有 think_token 字段。但下游做 GGUF 转换的脚本绝大多数没把它带过来。结果就是 inference engine 得写 model-specific 的特例代码去识别”这段是思考、那段是回答”。
3 · 多模态 projection 破坏了单文件叙事
GGUF 主打”一个文件搞定一切”。多模态模型的视觉投影部分目前一直得作为单独文件分发。建议:把 projection weights 也打包进 GGUF。
4 · 没有 capability flags
模型支不支持图像?tool calling?thinking?现在全靠”看 model 名字猜”,没有任何 capability declaration 字段。
这不是新模型发布的新闻,是格式工程债的盘点。在开源生态里很少有人主动做这种事——大家都在改 inference engine,没人愿意碰底层格式。但 GGUF 越普及,这些洞会越来越贵——每加一个新模型、新模态、新 reasoning 能力,都得在 N 个引擎里各打一遍补丁。把这事写下来,本身就是一种推动。
转给那个还在 llama.cpp 里手写 tool-call parser 的朋友。
关注 @svtransit1 · 写给真在用 AI 的人
完整链接 · 评论区取 ↓
#AI #LocalLLM #GGUF #llamacpp #LLM
原始来源:https://nobodywho.ooo/posts/whats-in-a-gguf/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS