
做 agent 不一定要 RAG。这周一篇论文实测下来:大多数场景里,grep 比 vector retrieval 准。
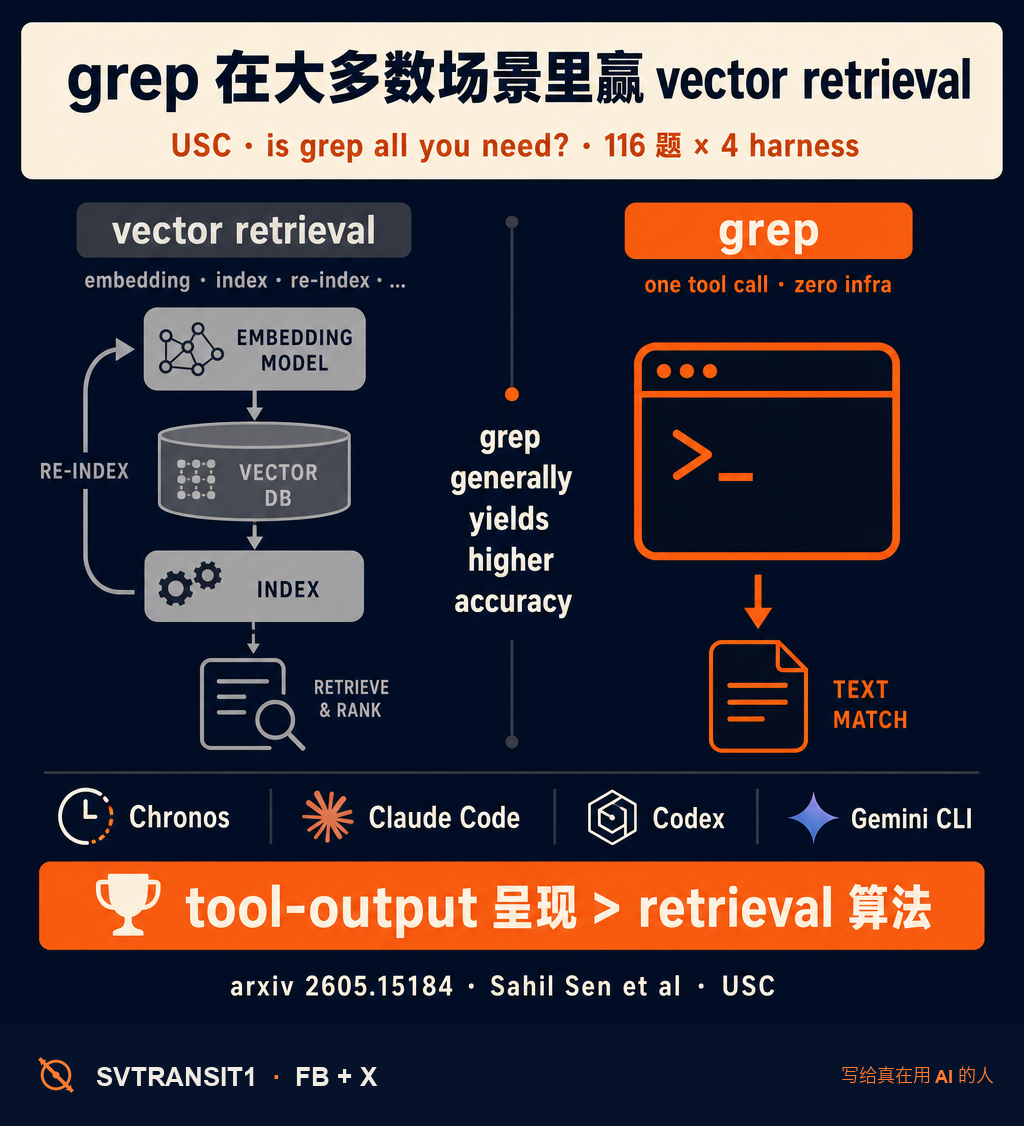
背景:过去两年大家做 agent 的 retrieval 层,默认套路是”embed 一切、丢进向量库、search 拿 top-K 喂模型”。这套路下到生产里,工程债很重——embedding 模型选型、index 维护、re-indexing 成本、stale 数据问题。但很多人没问过一个最基本的问题:这真的比一个简单的 grep 强吗?
USC 一组人(Sahil Sen 等)这周挂出来 “Is Grep All You Need? How Agent Harnesses Reshape Agentic Search”。他们做了两个实验:
实验一:116 道问题,grep vs vector retrieval,跑在四个 harness 上——Chronos、Claude Code、Codex、Gemini CLI。测两种工具输出展示方式(inline vs file-based)。
实验二:在 grep-only 和 vector-only 两种配置上,逐步往上下文里灌无关历史,测稳健性。
三条对得起对比的轴:
准确率——他们的结论很直接:”grep generally yields higher accuracy than vector retrieval in our comparisons in experiment 1.”
工程成本——grep 不要 embedding 模型、不要 index、不要 re-index 流水线。给 agent 一个 ripgrep 工具调用就行。vector retrieval 那一整套基础设施直接省掉。
harness 敏感性——但他们也补了一个 caveat:”overall scores still depend strongly on which harness and tool-calling style is used”。意思是,搜索方法的选择没有”tool output 怎么呈现给模型”重要。Claude Code 的 file-based 调用 和 Codex 的 inline 调用,在同样数据上得分差别大于 grep vs vector 的差别。
谁该看?如果你做 coding agent、文档检索 agent、log-diving agent——任何”数据本身是文本、有结构线索”的场景——这篇值得认真读。结论很可能是”你的 RAG 是过度工程化的”。
但,如果你做的是 semantic search(用户用自然语言问”那次跟 Mary 讨论 latency 的会议结论”),vector retrieval 仍然有价值——grep 不知道 latency ≈ 性能 ≈ 速度 是同义。
这套调研的更大意义:agent infra 圈在 2024-25 闷头加了一堆 RAG 层,默认 vector 是”现代化”——但 agent harness 的 tool-output 设计,比 retrieval 算法本身影响大得多。半年内,会有一波”我们把 vector 拆了”的工程反向潮。
转给那个还在折腾 RAG pipeline 的朋友——这篇值得吃完再做下一个 PR。
关注 @svtransit1 · 写给真在用 AI 的人
来源 · 评论区取 ↓
#AI #AIagent #RAG #ClaudeCode #grep
原始来源:https://arxiv.org/abs/2605.15184
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS