
"我做 SFT 微调,模型越练越忘记预训练学过的东西——这事有解吗?"答案是有的,一行代码改 loss。
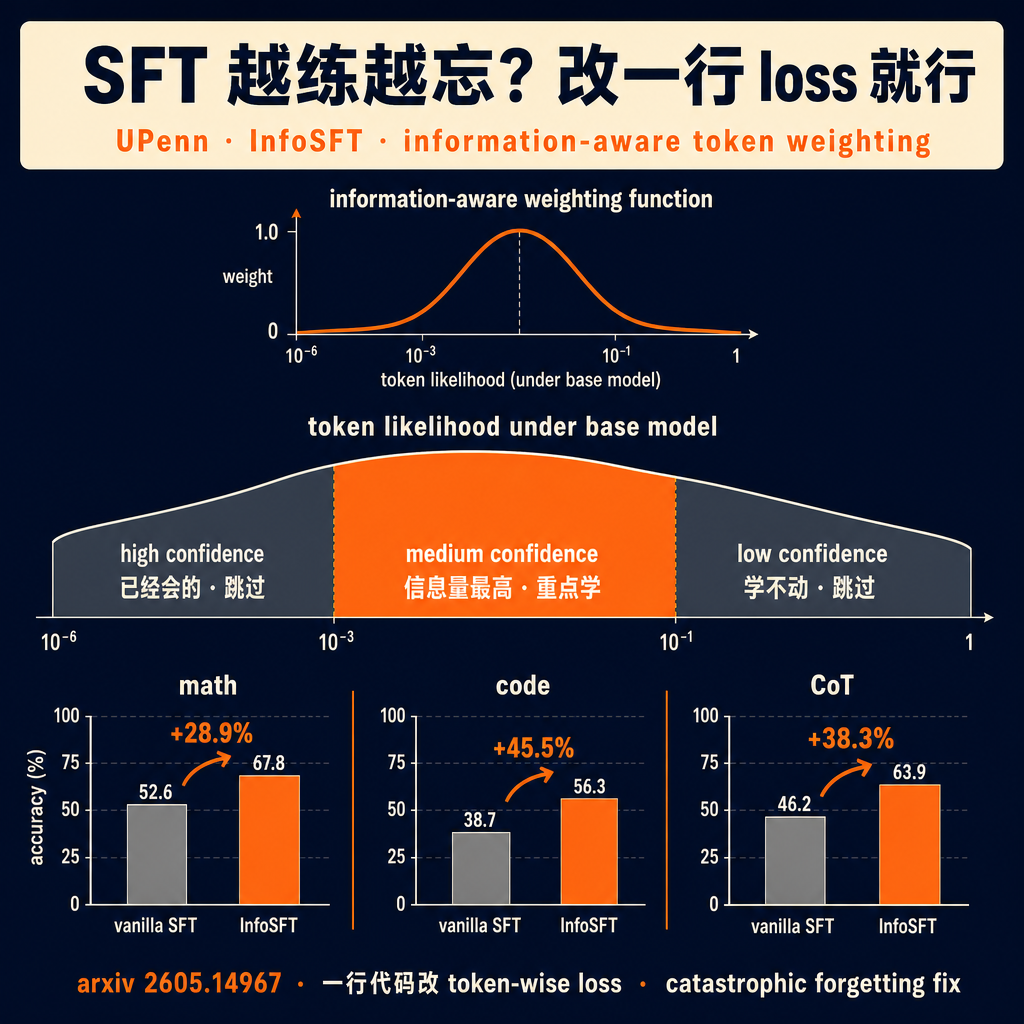
大多数人做 SFT 直接套 vanilla cross-entropy,每个 token 同等权重。结果就是模型在你的小数据集上死命拟合,把原本会的能力给磨没了——这就是 catastrophic forgetting 的工程版。问题不是”数据集太小”,是 loss 函数没在挑该学的 token。
UPenn 的 Hamed Hassani 组(还有 George Pappas)这周挂了 InfoSFT,做法很干净:只对 medium-confidence 的 token 加权。base model 已经会的(高 confidence)→ 不学,跳过。base model 完全不会的(低 confidence)→ 不学,跳了也学不动还会 destabilize。介于两者之间、信息量最高的 token——重点学这些。一行代码的事,改在 token-wise loss 上,基础设施完全不动。
实测在 math、code、chain-of-thought 三类任务上都打过 vanilla SFT 和”likelihood-weighted”基线。更重要的是,保住了预训练阶段那些”原本就会”的能力——这才是 SFT 工程师真正在意的 metric。
落地实操:你下次跑 SFT,看一下每个 token 在 base model 下的 likelihood。卡一个 medium 区间(论文给具体的窗口和权重函数),只在这个区间内回传梯度。其他 token 权重按论文公式压一压。一晚上能跑出对比。
这一类”loss-shape engineering”过去两年低估了——大家都在卷数据集、卷 RLHF、卷 reward model。但 SFT 还是 production stack 里最便宜、最确定的环节,在它上面挤出 5-10% 的保留能力收益,边际成本几乎为零。
转给那个还在用 vanilla SFT 然后困惑”为什么模型变笨了”的朋友。
关注 @svtransit1 · 写给真在用 AI 的人
完整链接 · 评论区取 ↓
#AI #LLM #SFT #FineTuning #UPenn
原始来源:https://arxiv.org/abs/2605.14967
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS