
你以为 HarmBench / InjecAgent / AgentDojo 这一波 LLM 安全 benchmark 已经覆盖了主要威胁?——这周一篇论文把这事的底揭开了:整个研究界已知的攻击,六大 benchmark 加起来,只覆盖了 25%。
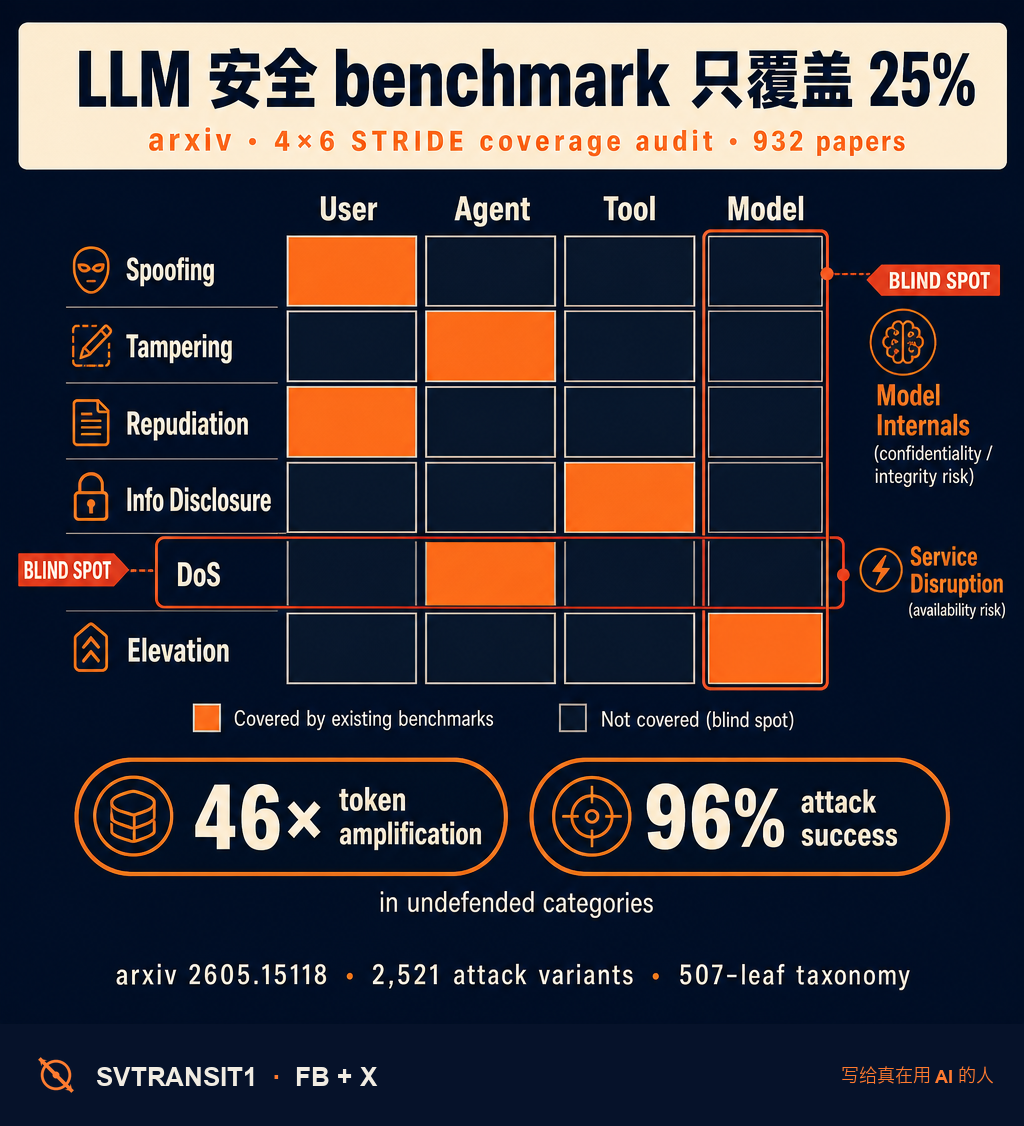
一组研究者(Karthik Raghu Iyer / Yazdan Jamshidi / Nicholas Bray / Alexey Shvets)这周挂的 “Talk is (Not) Cheap”。他们做了一件笨功夫但价值极高的事——从 2023 到 2026 的 932 篇 arXiv 安全论文里,系统抽取攻击手法,构造了一个 507 叶子的攻击分类树。然后用一个 STRIDE 风格的 4×6 矩阵(目标维度 × 技术维度),把六大主流 benchmark(HarmBench、InjecAgent、AgentDojo 等)的覆盖情况画出来。
这个 4×6 矩阵的设计是关键——STRIDE 是 Microsoft 用了 20 年的威胁建模框架,把任何系统的攻击面分到 6 类:Spoofing、Tampering、Repudiation、Information Disclosure、Denial of Service、Elevation of Privilege。把它套到 LLM 上面,等于强行让你检查每一类的覆盖度,而不是只盯着自己擅长的角落。
结论一(分散):2521 个独立的攻击 group,平均每个攻击有 29 个不同的命名变体。”prompt injection”、”role hijack”、”system prompt leak”——同一个东西在不同论文里叫不同名字。整个领域的命名碎片化严重,导致系统性比对几乎没法做。
结论二(blind spot):六大 benchmark 占据的格子”基本不重叠”——它们各自在 4×6 矩阵的局部检查,合起来还是只覆盖 25% 的攻击面。
结论三,这条最扎心:整整两类攻击没有任何公开 benchmark 评估——Service Disruption(让模型卡死、token 爆炸)和 Model Internals(模型权重 / KV cache 攻击)。而这两类不是边角案例:论文里这两类的实测,token 放大率到 46×,攻击成功率 96%。
你把这三条放在一起看:大部分团队拿 HarmBench 跑过 + 几个 jailbreak prompt 测过,就认为模型”上线 safe”。但你的 benchmark 选型本身就是”看着路灯下找钥匙”。Service Disruption 这类——用一个特殊构造的输入让模型陷入死循环或 token 爆炸——可以让生产环境的 API 成本一夜翻 50 倍。Model Internals 攻击可以泄漏权重、KV cache 缓存里的对话历史。这些都没在你的安全报告里。
这篇 paper 的真正价值不在”指出问题”,而在”放了一个可扩展的 artifact”——把这个 507-leaf 分类树 + STRIDE 矩阵开源了。未来做安全研究的人有了对比基准——你 claim 的覆盖率有多少、补的是哪一格,可量化。
更深一层:507 个叶子里,401 个是”data-populated”(有实际攻击数据支撑),106 个是”threat-model-derived”(理论推导但还没有人具体实施)。后面这 106 个,等于一份预测——这些攻击形式现在没出现,但攻击者迟早会走到这条路上。把它写下来,等于给红队提前画了地图。
工程含义?如果你的 LLM 产品在 production,且只跑 HarmBench/InjecAgent 那一套就放心了——这周就把 Service Disruption + Model Internals 这两类加上自定义红队测试,不然下一波被攻击你都不知道是怎么死的。
转给那个还在用 HarmBench-only 跑 safety eval 的朋友——他需要看完这篇再做下一个 PR。
关注 @svtransit1 · 写给真在用 AI 的人
链接 · 👇 第一条评论
#AI #LLMSecurity #RedTeam #AISafety #Benchmark
原始来源:https://arxiv.org/abs/2605.15118
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS