
不重训、不微调,Gemini 3.1 Pro 的 Codeforces Elo 直接涨了 405 分——靠的是把推理这件事变成"评委制选秀"。
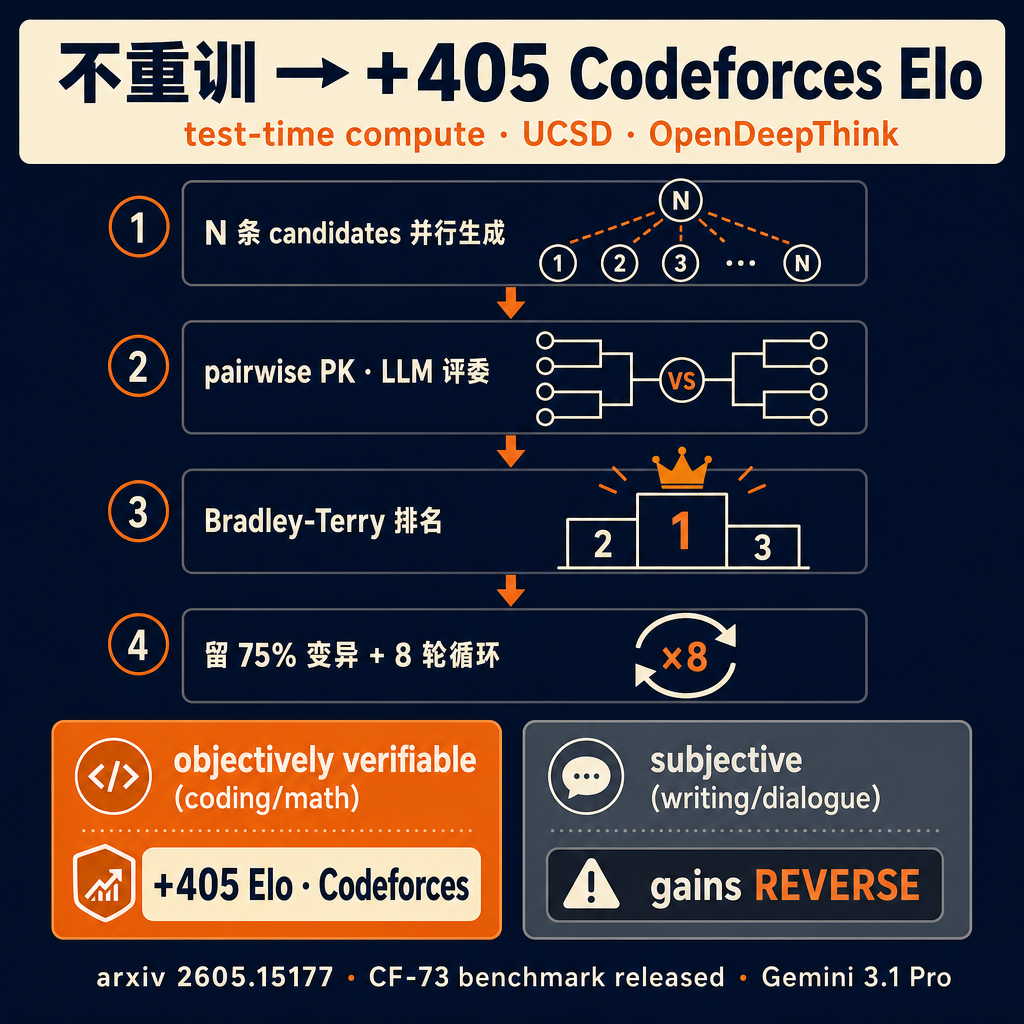
UC San Diego 一组人(Jingbo Shang 在内)这周挂的 OpenDeepThink,本质上是一个 test-time compute 的新组合。论文逻辑这样:同一道题,先让模型并行生成 N 条推理 candidates;再让另一个 LLM 做 pairwise 评委,两两打架;评出来的得分用 Bradley-Terry 排名(同一套统计模型也用来给国际象棋大师排名);留下排名前 75%,让模型对它们做”自然语言批评 + 变异”,继续下一轮;循环 8 次。
整个过程没有训练,没有 RLHF,没有 SFT。就是把更多算力花在推理路径的探索 + 评估上。
效果是真硬:Gemini 3.1 Pro 在 Codeforces 上 Elo 涨了 405 分,大概 27 分钟跑完 8 轮(每题)。换个直观参照——这一跳相当于把模型从”中游候选”直接拉到接近 Master 段位的水准,而模型权重一行没动。
他们顺手放出来一个叫 CF-73 的 benchmark——73 道 Codeforces 题,Grandmaster 标注,跟官方判定的一致率 99%。这意味着以后做这类研究有了相对干净的对照基准。
但论文最有意思的地方,不是 +405——是这一句:performance gains concentrate in objectively verifiable domains while reversing in subjective ones。
翻译成大白话:这套方法在”能被自动判对错”的任务上(竞赛题、单元测试、数学证明)收益最大;但在”判断好坏靠人感觉”的任务上(写作、设计、对话语气),Bradley-Terry 评委制反而可能让答案变差。
这事的深层原因不难想:让 LLM 给 LLM 当评委,在客观题上 LLM 的判断收敛到正确答案;但在主观题上,LLM 评委的偏见会被 8 轮放大——选秀循环把”评委喜欢”的答案推上去,而不是把”用户真的喜欢”的答案推上去。
这条 caveat 才是未来一段时间 test-time compute 路线要面对的硬墙。短期内,做 coding agent、数学求解、自动测试这一波的人,可以直接抄 OpenDeepThink 的循环——边际收益清楚。但做对话产品、写作助手、UI 设计的,得绕开,或者发明一套能感知 subjective domain 的中止机制。
为什么是 Bradley-Terry 而不是直接打分?因为单值打分的偏见随对照而变,LLM 评委今天给 7 分明天给 8 分都是常态。但 pairwise 比较稳定得多——”A 比 B 好”这个判断的 noise 比”A 是 8 分”的 noise 低一个数量级。Bradley-Terry 把一堆 pairwise 结果汇成全局排名,统计学家几十年前在国际象棋圈就用过。把它套到 LLM 推理选秀上,等于把一个成熟的统计工具搬到了一个新场景。
实际算力开销?一道题 8 轮 × N candidates × pairwise 比较——大概是 single-shot 的 几十到上百倍。对竞赛题这种”一道题十万美元 prize”的场景值得;对在线推理产品,得做 caching、提前 stop、subjective-domain detection。这些工程化空间足够养一家 startup。
Codeforces 评分多 405 分听起来像数字游戏,但放到生产 agent 里——能稳定打过 Grandmaster 的 coding agent,客户愿意付的钱完全不一样。这条 path 半年内会有 startup 卷起来,卷的不是模型大小,是”在固定模型上挤出多少压榨空间”。
也间接给了一个 framing:模型本身已经是过去式,test-time 的策略层正在变成新一代的”模型设计”。
转给那个还在用单次 sampling 跑 coding agent 的朋友。
关注 @svtransit1 · 写给真在用 AI 的人
链接 · 👇 第一条评论
#AI #LLM #TestTimeCompute #CodingAgent
原始来源:https://arxiv.org/abs/2605.15177
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS