
speculative decoding 这条 inference 加速路线,过去一年是默认选择——但有人在用另一种思路把 5 倍速度搞出来,而且不要 draft model,不要双 KV cache。
GitHub 上叫 Orthrus,作者 chiennv2000,这周冲到 100 多星但已经被 HN 注意到了。MIT license,代码完整,跑 Qwen3 三个尺寸——1.7B、4B、8B 都验证过。
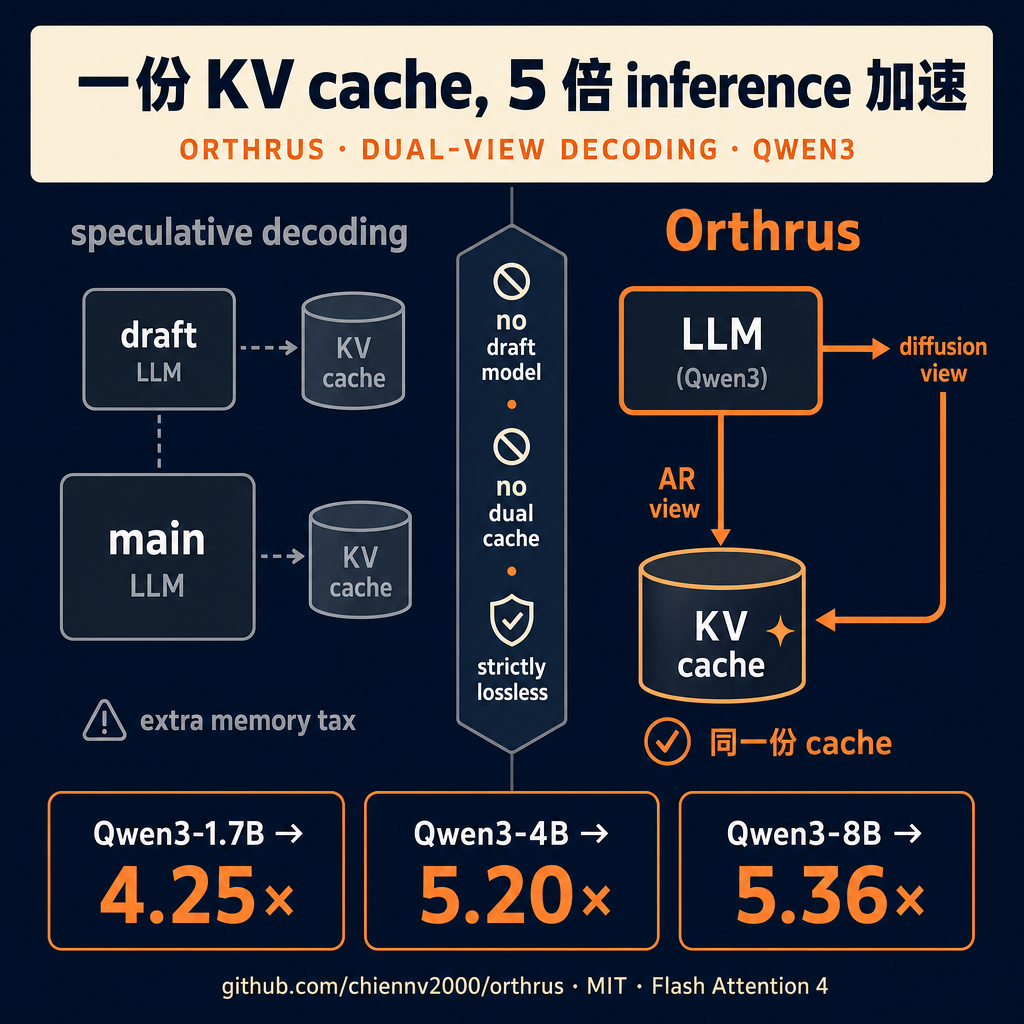
它解决的痛点是这样:speculative decoding 的工作原理是让一个小的 “draft model” 猜下 N 个 token,主模型验证。问题在于——你得多带一个小模型在显存里,还得维护两套 KV cache,而 draft 偶尔猜错时浪费的算力也不少。在边缘设备和移动端,显存就那么点,这个 overhead 很贵。
Orthrus 的思路反过来——不要 draft model,把主模型变”双视角”:一个 autoregressive view(原本的逐 token 生成,保正确性)+ 一个 diffusion view(并行预测多个 token,共享同一份 KV cache)。两个 view 在同一个模型权重里共存,通过对 16% 的参数做 fine-tuning 注入并行生成能力,base LLM 完全 frozen。
效果是真的硬:Qwen3-1.7B 平均加速 4.25×,Qwen3-4B 平均 5.20×,Qwen3-8B 平均 5.36×。论文标题里那个 “up to 7.8×” 是峰值——不是平均,作者很诚实地把平均值列在表格里。
更关键的是它是”strictly lossless”——生成的 token 序列跟原始模型逐字相同,不是”差不多”。这意味着可以直接替换生产环境里的解码层,不用重新跑 evaluation。
技术细节里有个 Flash Attention 4 的支持——这意味着作者跟得很紧,FA4 不少团队都还没切过去。硬件要求 CUDA,边缘场景能不能跑得看你的 GPU 余量。
这条路线为什么有意义?inference 的瓶颈过去两年大家都假设是”compute-bound”,所以堆芯片 / 堆速度优化。但实际生产里,瓶颈很多时候是 memory-bound——尤其是 KV cache 占的那部分显存,在多用户共享 / 多并发 batch 的时候,谁先把这块挤瘦谁先赢。speculative decoding 让你多吃一份显存(draft model + 双 KV);Orthrus 是反过来挤这块显存。
工程含义?如果你做 inference platform、做边缘 LLM 部署、或者做 on-device 推理引擎——这条 path 比 speculative decoding 更值得跟。speculative 那一波过去一年大家挖得很深,Orthrus 这种 “draft-less” 路线刚开始,差距还在加大。
代码已经放出来了,模型权重在 HuggingFace 上也有。今晚就能跑通。
转给那个还在 EAGLE-3 / DFlash 那条 speculative decoding 路线挖的朋友——这边的边际收益可能更高。
关注 @svtransit1 · 写给真在用 AI 的人
完整链接 · 评论区取 ↓
#AI #LLM #Inference #Qwen3 #FlashAttention
原始来源:https://github.com/chiennv2000/orthrus
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS