
花 4299 美元买 M5 Max MacBook 跑本地 LLM——按 10 年寿命算,每百万 token 成本 1.61-4.79 美元。OpenRouter 上同款 Gemma4 31B,38-50 美分。"本地省钱"这个 mental model,数学上不成立。
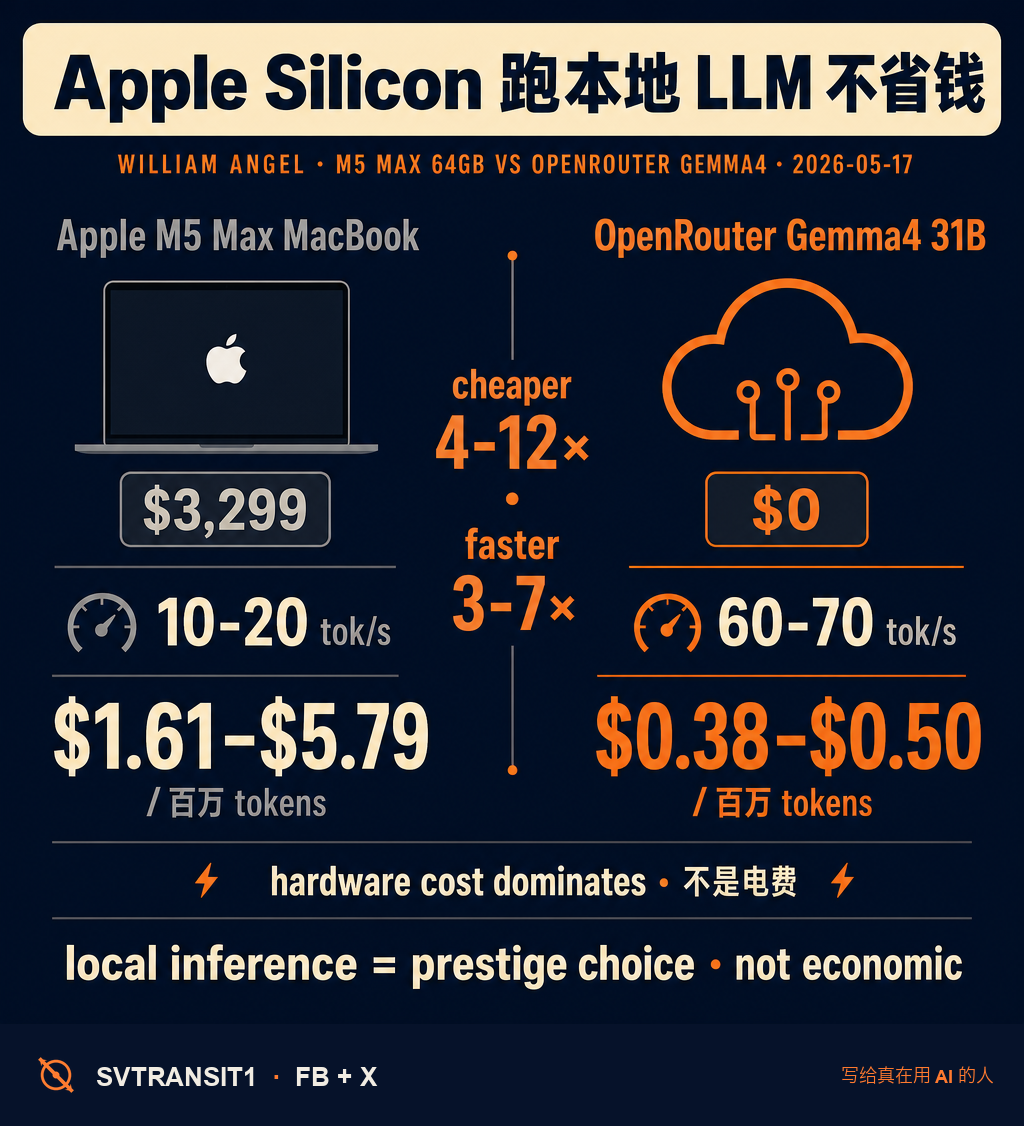
William Angel 这周写了一篇博客,做了件大家应该早就做但很少有人认真做的事——把 Apple Silicon 跑本地 LLM 的真实成本算到每个 token。设备:14 寸 M5 Max + 64GB RAM,Apple 官网现在 $4,299。
他测的运行参数:M5 Max 上 Gemma4 类的模型,大概 10-20 token/秒,功耗 50-100 瓦。每小时输出大约 36,000 token。然后算硬件折旧 + 电费(纽约电价 $0.18/kWh),按 3、5、10 年寿命三档分别折算。
数字摊开来看,扎心的是这两个:
第一,每百万 token 成本 $1.61 到 $4.79(10 年和 3 年寿命的端点)。OpenRouter 上 Gemma4 31B,每百万 token $0.38 到 $0.50——便宜 4 到 12 倍。哪怕用最乐观的 50W 持续输出 + 10 年使用周期,本地成本 $0.40-$1.20 依然贴着 OpenRouter 的上限。
第二,速度差 3 到 7 倍。OpenRouter 上 Gemma4 服务商能跑到 60-70 token/秒,M5 Max 上 10-20。也就是说本地不只是贵,还慢。
他的核心论点是:硬件成本主导,不是电费。大家做本地 LLM 的成本分析时本能去算”每度电几度多少钱”,其实在 Apple Silicon 上电费占比很小,真正的钱被压在 $4299 这个初始投资里。一旦你算上摊销,本地推理就不再是”省钱方案”,是”prestige 选择”——你愿意为离线、为隐私、为不依赖第三方付溢价,但别假装这是经济决策。
我觉得这件事值得本地 LLM 圈认真思考。过去两年大家给 M-series Mac 跑 LLM 写了一堆配置教程、推荐了一堆量化方案,默认前提是”本地总比云便宜”。这个前提在 OpenRouter / Together / DeepInfra 把 token 价格打到 $0.50 以下之后,已经站不住了。剩下能站住的理由——隐私、离线、demo 场景、企业内部数据合规——这些都成立,但和”省钱”无关。
下一波 mental model 调整大概是:本地推理 = 战略选择,云推理 = 经济选择。两者不冲突,但不该互相伪装。
还有一个潜台词值得留意——这个分析里的”OpenRouter 便宜”很大程度上靠的是模型 commodity 化和 inference provider 的价格战。Together / Fireworks / DeepInfra 都在 race-to-the-bottom 上同一艘船。这种 token-as-utility 的趋势让本地推理的边际优势被持续挤压。除非 Apple 把硬件价格腰斩,否则未来这个差距只会更大。
转给那个还在为给 Mac 加 64GB RAM 内疚的朋友——这是 prestige 消费,不是省钱。
关注 @svtransit1 · 写给真在用 AI 的人
链接 · 👇 第一条评论
#AI #LocalLLM #Hardware #Economics #AppleSilicon
原始来源:https://williamangel.net/blog/2026/05/17/offline-llm-energy-use.html
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS