
"做 long-context agent,上下文越长显存越爆,但又不能让模型忘掉前面 100 轮——怎么办?"答案不是把 context window 拉长,是给模型挂一个 8×8 的在线记忆矩阵。
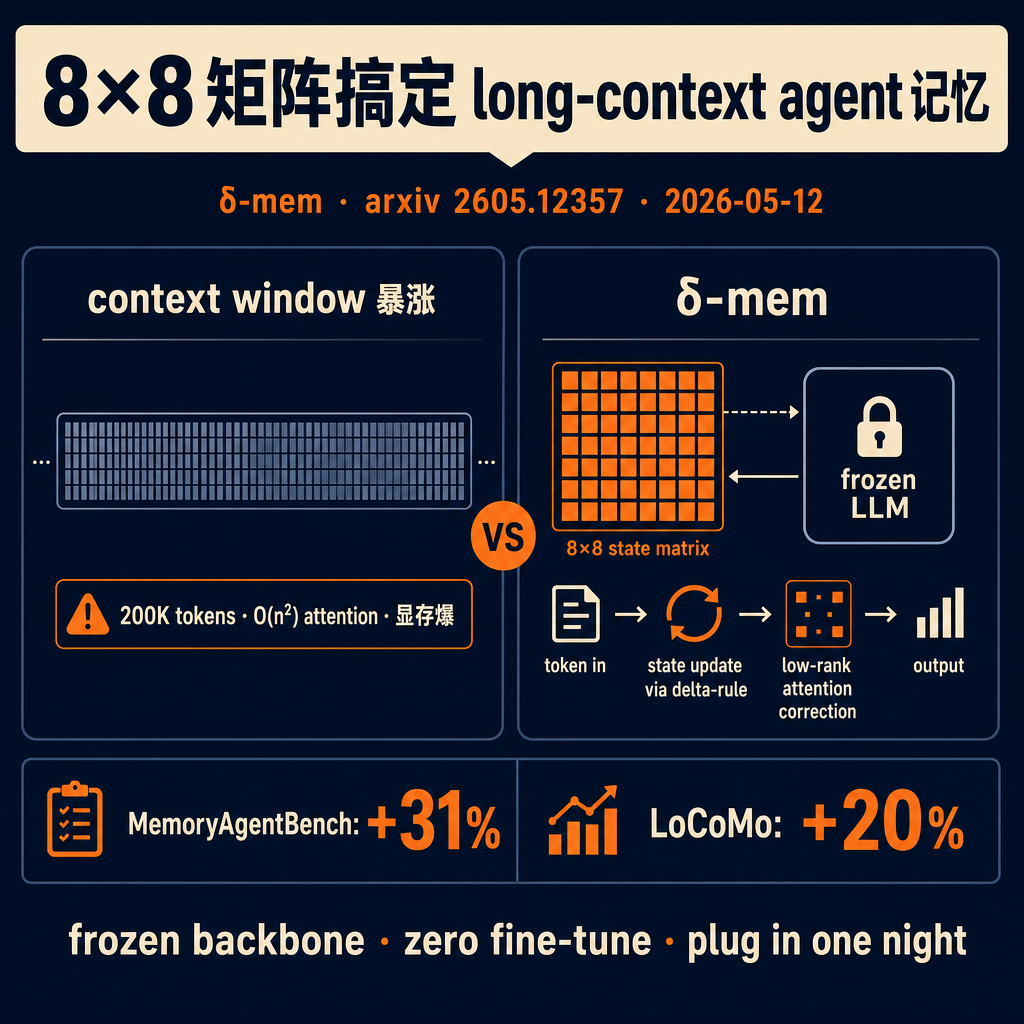
大多数团队遇到这个问题第一反应是”换 200K context 的模型”。但 200K context 的 attention 是 O(n²),显存还是要爆;就算工程上能撑住,推理延迟会拖到不可用。问题不在 context 窗,在”怎么把已经发生过的对话压缩进一个固定大小的记忆里”。
这周一篇 arxiv 上挂的 δ-mem 给了一个特别小的、特别精巧的解法:
挂一个 8×8 的 online state matrix 在已经训好的模型旁边(backbone 完全 frozen)。用 delta-rule 学习规则——每来一段新 token,这个状态矩阵更新一次,然后给 backbone 的 attention 输出一个 low-rank 修正项。整个机制几十个参数就能 plug 上去,不需要重新 fine-tune,不需要替换模型。
效果硬:MemoryAgentBench 上 1.31×,LoCoMo 上 1.20×,这两个 benchmark 专门考”长对话能不能记住之前的细节”。8×8 矩阵这么小却拿到这种 lift——意味着 LLM 内部其实有大量”重复但没被压缩”的状态,δ-mem 强制压成 64 维之后,模型反而学得更准确。
我觉得这件事真正有意思的不是数字。是它表明 long-context 的”工程债”还有很多廉价解法没被发掘——大家默认 “context 不够就加 token”是错的 mental model,真正的进路是 “怎么把上下文压成小尺寸的有意义状态”。
落地实操:δ-mem 的 8×8 状态 + delta-rule 更新可以在一个晚上挂到任何 Qwen / Llama / Mistral 的 inference 栈里。代码论文里有 reference。如果你做 multi-turn 客服 agent、教学 agent、或者任何需要长时记忆但又不想加 RAG/vector 那一坨基础设施的场景——这条路值得跑一遍。
转给那个还在用”扩 context window”硬解长记忆问题的朋友。
关注 @svtransit1 · 写给真在用 AI 的人
完整链接 · 评论区取 ↓
#AI #LLM #AgentMemory #FrozenBackbone
原始来源:https://arxiv.org/abs/2605.12357
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS