
在 diffusion model 圈做多任务训练这两年是个公开的痛点——同一个 base model 同时塞图像生成、视频生成、3D 生成、audio 生成,任务之间互相干扰,梯度方向打架,最后哪个任务都做不到 single-task 的水准。这周一组研究者(Yu Liu / Zuxuan Wu 等十人)挂了 DiffusionOPD,把这事儿用 distillation 的角度重新拆开来做。
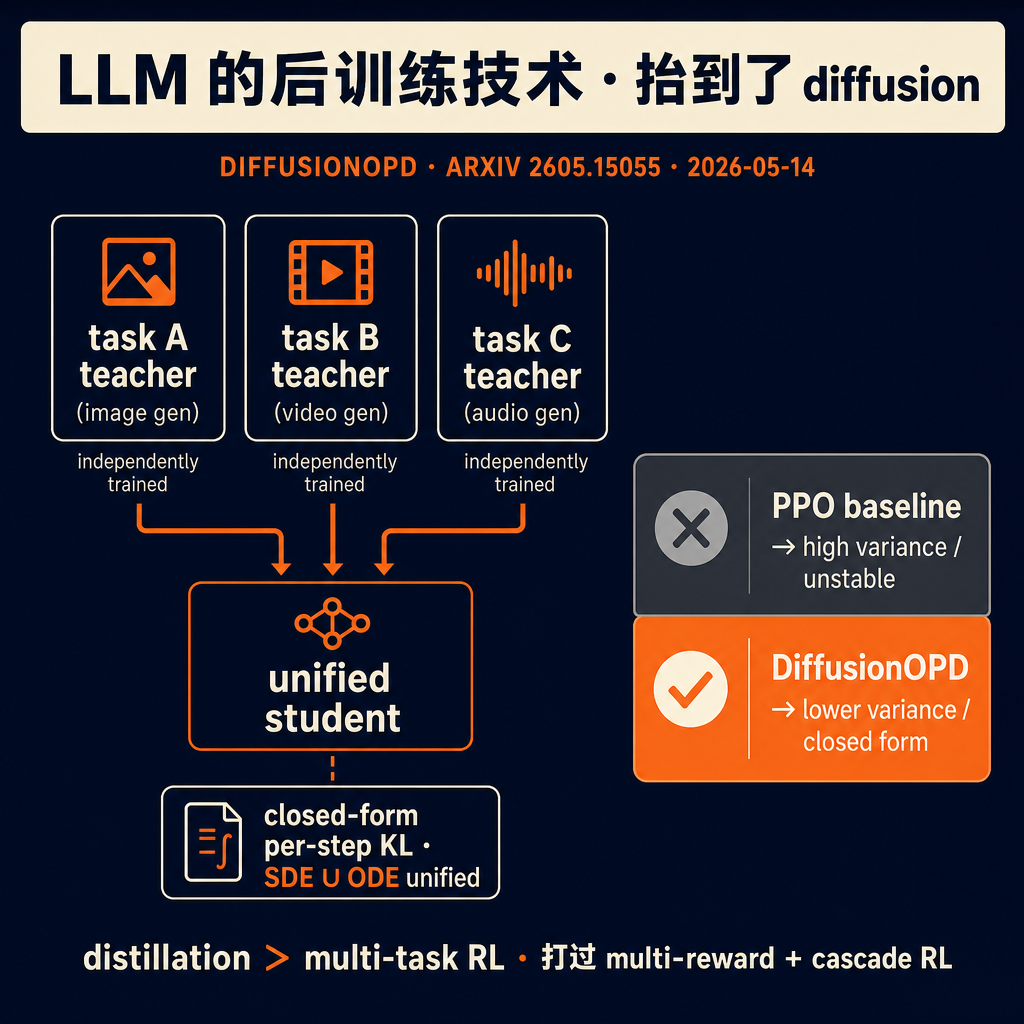
做法是这样:不要试图让一个 student 直接 multi-task 训练。先给每个任务训一个 task-specific teacher,各自单独最优;然后把 N 个 teacher 的能力 distill 进一个 unified student 模型。teacher 之间不直接对话,student 跟每个 teacher 单独学,最后吸收所有任务能力。
这个 framing 看似简单,但他们的真正贡献在理论层:把 On-Policy Distillation(OPD)的原始公式——本来是为离散 token policy(LLM-style RL)设计的——抬到 continuous-state Markov processes 上,推导出一个 closed-form 的 per-step KL 目标。这个推导让 SDE-based refinement(随机微分方程,主流 diffusion sampling)和 ODE-based refinement(确定性流匹配)在同一个理论框架下统一了。
更关键的实测结论:他们的 OPD 公式比传统 PPO-style policy gradient 方差更低、泛化更好。这条很硬——过去做 diffusion RLHF 的人都知道 PPO 在 diffusion 上 noise 巨大、训练极其不稳定,通常需要大量 trick 才能跑。DiffusionOPD 的 closed-form KL 直接绕过 PPO 的 high-variance 问题。
实验对照里把 multi-reward RL 和 cascade RL 两个 baseline 都打过了。
这件事的意义比”又一个 diffusion 训练 paper”大。它指向一个更深的趋势——LLM 后训练阶段开发出来的 RL/distillation 技术,正在 system-级 地迁移到 diffusion model。OPD 本来是 LLM agent 训练里的小众工具,DiffusionOPD 把它推广成 continuous-state 通用框架,接下来很可能会有更多 LLM 后训练 trick 在 diffusion 圈复用。
落地实操:如果你做 video / image / audio gen 的多任务模型(比如同一个 model 既要生成视频又要做 audio matching),DiffusionOPD 这条 path 值得跑。如果你做 single-task,SFT 加 reward shaping 仍然够用,边际收益不显著。
代码暂时还没放出来(arxiv preprint)。要预测一下 release 时间窗,作者列表里有些活跃的视频生成研究者,正常 release 周期是 1-2 个月内。
更深一层的影响——如果 OPD 的 continuous-state 版本真的能稳定打过 PPO,那 diffusion model 的 RLHF 框架可能要重写。过去两年 video gen / image gen 的 alignment 工作大多用 DDPO、DPOK、PPO 这一套,稳定性差是公认问题(显存爆、训练崩、需要大量 reward model 工程)。DiffusionOPD 提供了一条更 principled 的路径:closed-form KL + 多教师拆分,工程难度降一档。
转给那个还在死磕 multi-task diffusion RL 的朋友——换个范式可能比加 trick 来得快。
关注 @svtransit1 · 写给真在用 AI 的人
链接 · 👇 第一条评论
#AI #DiffusionModel #Distillation #RLHF #LLMresearch
原始来源:https://arxiv.org/abs/2605.15055
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS