
2026 年的 voice agent 圈,12 家头部系统全部测了一遍——没有一家能同时在准确率和对话体验上拿到 50 分。
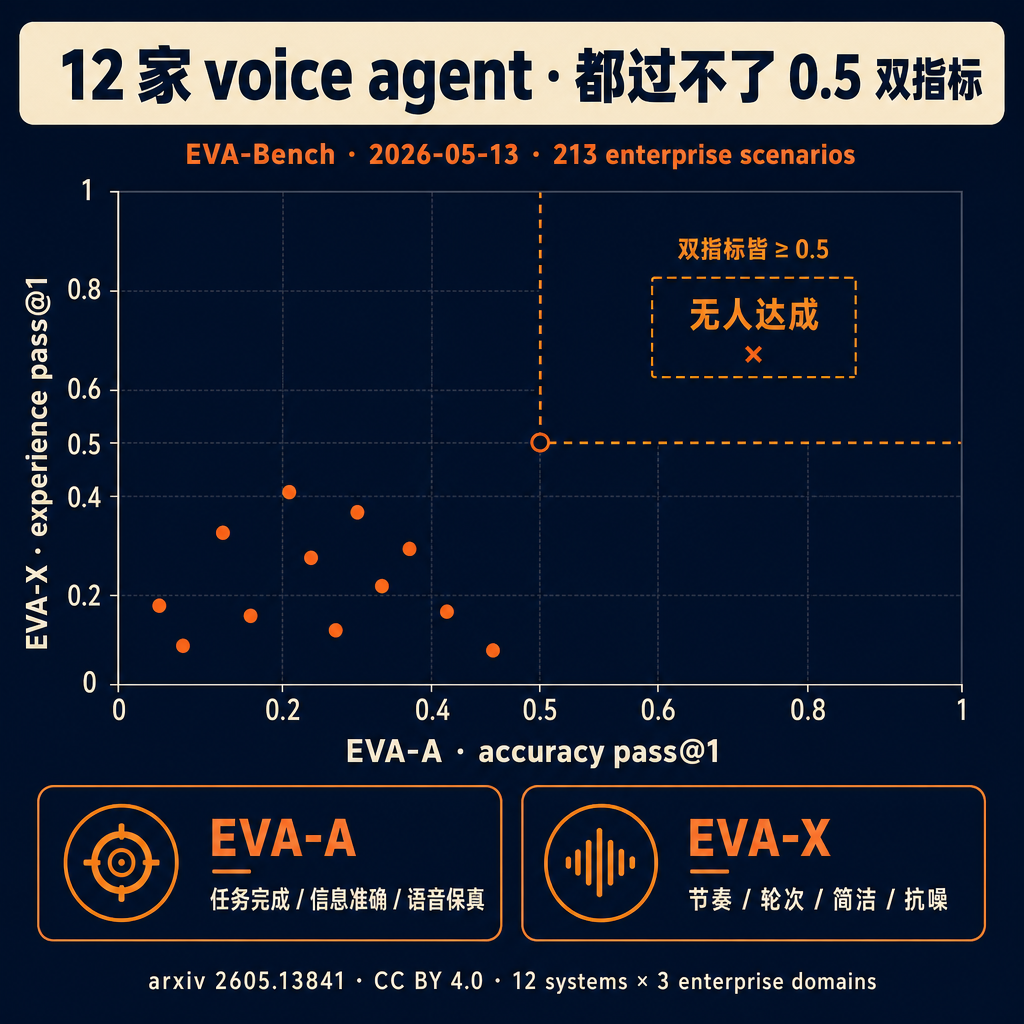
这不是行业黑话,是实测数据。一组研究者(15 位作者,看名字结构像是企业 voice AI 团队)这周挂的 EVA-Bench:第一个把”voice agent 评测”拆成两条独立轴的端到端 benchmark。EVA-A 衡量 accuracy——任务有没有完成、信息有没有错、语音有没有保真;EVA-X 衡量 experience——对话节奏、轮次接续、简洁度、抗噪/抗口音扰动。
213 个 enterprise 场景,跨 3 个领域,12 套主流 voice agent 都跑了一遍。关键结论:没有任何一套系统能同时在 EVA-A 和 EVA-X 的 pass@1 上超过 0.5。翻译一下:行业最好的也只能”准确但用户感觉不好”或者”体验好但容易答错”,还做不到两者兼得。
CC BY 4.0 开源,代码放出来了。
我觉得这件事的真正价值不是”voice agent 不行”——是 framing。过去两年 voice AI 圈所有的 demo 都在卷”准确度”或者”自然度”单一维度,营销话术也是。EVA-Bench 第一次强制把两个轴同时放在桌面上,任何 voice 产品现在都得回答:”你 EVA-A 多少?EVA-X 多少?”——双维度的标杆出现意味着行业从”看 demo” 变成”看分数”。
转给那个在做 voice agent 产品的朋友——下一轮融资 pitch 里没这两个数,资方大概会问。
关注 @svtransit1 · 写给真在用 AI 的人
来源 · 评论区取 ↓
#AI #VoiceAgent #LLM #Benchmark
原始来源:https://arxiv.org/abs/2605.13841
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS