
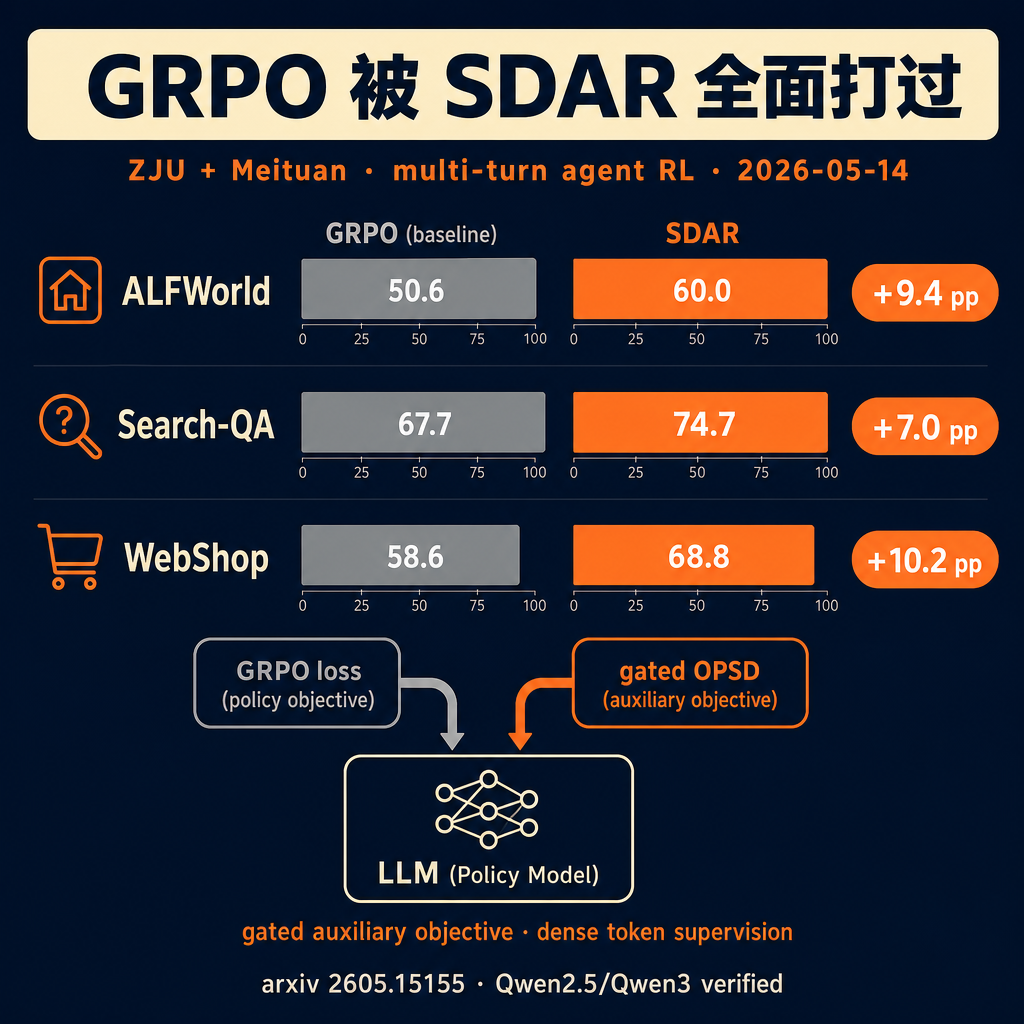
做 multi-turn agent 训练这两年的默认套路是 GRPO,这周一篇 ZJU + Meituan 的论文,在三个 benchmark 上把 GRPO 全面打过——平均 +8.9 个百分点。
背景说清楚——做 multi-turn agent(像 web 浏览、家务执行、搜索问答这类需要多轮决策的任务),你需要 RL 微调让模型学会”决策序列”。GRPO(Group Relative Policy Optimization)是过去一年的事实标准,DeepSeek 的 R1 让它出圈。问题是 GRPO 在 multi-turn 场景下”稀疏奖励 + 长 horizon”组合很容易学崩——一个失败 trajectory 拖累整组样本。
ZJU + Meituan 这周挂的 SDAR(Self-Distilled Agentic RL)做了一个看起来简单但工程上很关键的设计:把 On-Policy Self-Distillation 当成 gated 辅助目标,绑在 GRPO 上做共同训练。OPSD 自己单独跑会过拟合,GRPO 单独跑会学崩——把两者糊在一起反而稳定下来,因为辅助目标对每个 token 都提供 dense 监督,RL 的 sparse reward 不够时它兜底。
三条对得起对比的轴:
ALFWorld(家务模拟器):SDAR vs GRPO 提升 9.4 个百分点。
Search-QA(多轮检索问答):提升 7.0。
WebShop(网购导航):提升 10.2,这条最直接相关 e-commerce agent。
三个 benchmark 加起来平均 +8.9pp,在 Qwen2.5 和 Qwen3 两代模型上都验证了。
谁该看?如果你做 e-commerce agent、工具调用 agent、或者任何”需要 multi-turn 状态管理 + RL 微调”的 agent——这条路线立刻可以替换 GRPO,工程改动也很小,只是多加一个 gated auxiliary loss。基础设施都不动。
如果你跑的是 single-turn / one-shot 任务(分类、问答、单步生成),那 GRPO 就够,SDAR 的额外开销不值。
Meituan 参与是个值得注意的信号——美团做 multi-turn agent 大概率不是给 LLM 论文写的,是给自己的内部产品(打车、订餐、购物导航这类多步 workflow)在用。论文发出来的同时大概率已经在生产 deploy。
转给那个还在用纯 GRPO 跑 e-commerce agent 的朋友——切到 SDAR 是 free lunch。
关注 @svtransit1 · 写给真在用 AI 的人
完整链接 · 评论区取 ↓
#AI #AIagent #RL #GRPO #Meituan
原始来源:https://arxiv.org/abs/2605.15155
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS