
每开一个新 session 都要重新解释一遍 architecture —— 这件事好像每个用 Claude Code / Codex / Cursor 的人都习以为常了。
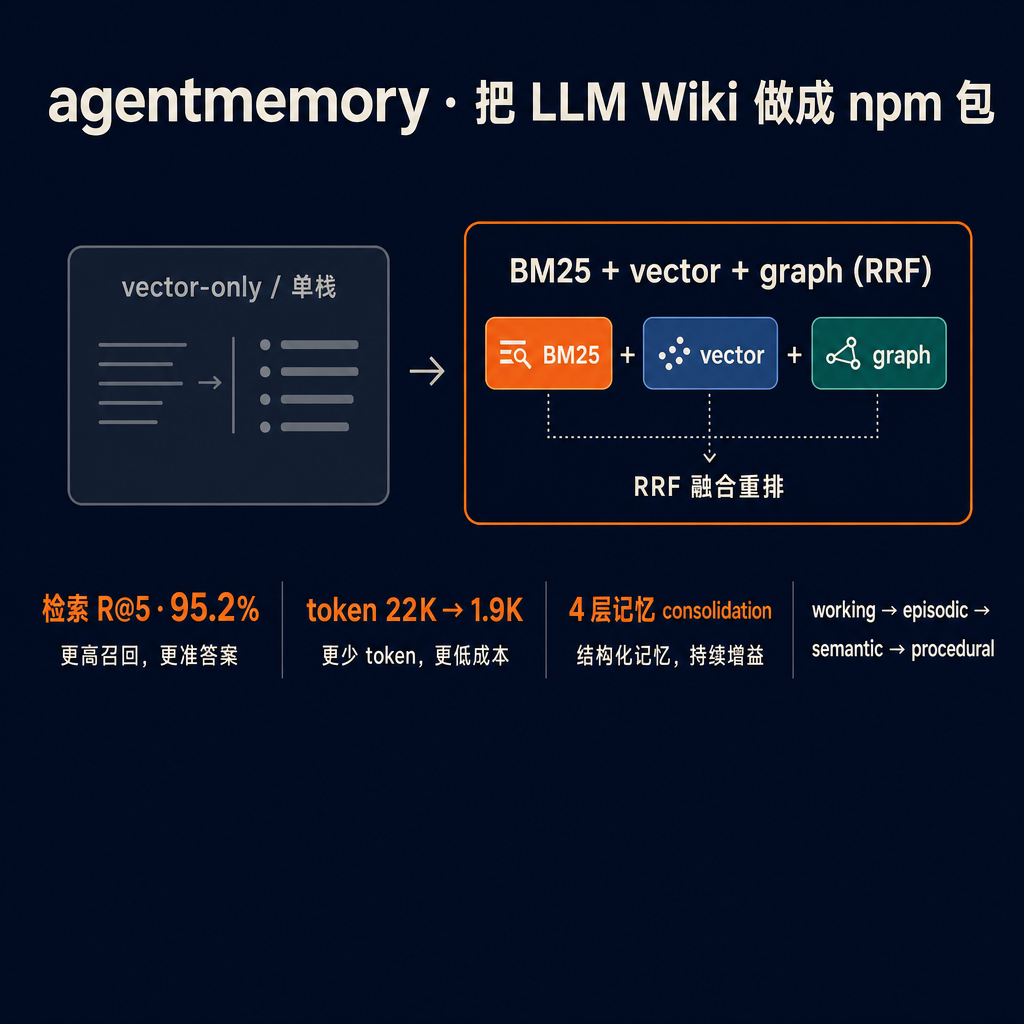
agentmemory 这周在 GitHub trending 顶上,12K 星。作者把 Andrej Karpathy 几个月前那条 “LLM Wiki” 的 gist 干成了能用 npm 装的工具。Gist 本身 1200 星 / 172 forks —— 原方案是人工维护一个 wiki 文件喂给 agent。agentmemory 把它做成跑在本地 3111 端口的 memory server,加了 confidence scoring、生命周期、knowledge graph、混合搜索。
技术栈值得拆开看一下。检索那块比常见的 vector-only 多了两栈 —— BM25 加 graph,三路用 RRF 融合排序。embedding 用本地的 all-MiniLM-L6-v2,无 API key、零外部数据库,不用挂 Qdrant 也不用 pgvector。
记忆结构按人脑那套抄的:working → episodic → semantic → procedural 四层 consolidation,配合 decay 和 auto-forget。听起来像营销话,但 benchmark 给得很硬 —— 检索 R@5 是 95.2%,token 消耗从一次 session 灌 22K+ 上下文,降到平均 1.9K 注入,砍掉 92%。BM25-only 的 ablation 也放上去做对照。
最实用的是兼容范围。Claude Code / Codex CLI / OpenClaw / Hermes / pi 是 native 插件 + hooks;Cursor / Gemini CLI / OpenCode / Cline / Goose / Aider / Windsurf / Roo / Claude Desktop 走 MCP;剩下走 REST API。15+ agent 共享同一个 memory server —— 意思是你今天在 Claude Code 里教它一遍 JWT auth 用 jose 不用 jsonwebtoken,明天换 Cursor,它还记得。
为什么这件事是个信号,不只是又一个工具?
过去两年 LLM 工程的默认思路是 “把 context 越塞越长”:Claude 1M、Gemini 2M、各种 RAG 方案。但用过 Claude Code 跑大项目的人都知道,塞到 100K 以上之后,模型对早期内容的注意力肉眼可见下降,而 token 费用是线性涨的。
agentmemory 的方法是反过来 —— 不要灌,要捕。Stop / SessionEnd hook 触发时,把这次 session 做了什么 silently 写进 BM25 + vector + graph 索引;下次 session 起来时,SessionStart hook 拿一个 token budget(默认 2000),用 hybrid search 把最相关的几条注入进去。整套机制听起来跟人睡眠期的记忆 consolidation 是一回事 —— 短期记忆按相关性和频次,被压缩成长期记忆,无关的衰减掉。
作者 README 里把它和 mem0、Letta、Khoj、claude-mem、Hippo 全比了一遍。最直接的对照:同样 240 条 observation,mem0 是 “全部塞进 context” 一次 22K+ token;agentmemory 是 hybrid search 取 top-K,1.9K token 搞定。
一行装完:npm install -g @agentmemory/agentmemory,然后 agentmemory connect claude-code,挂上就跑。我自己没跑过,但如果你已经被 .cursorrules 200 行上限和 CLAUDE.md 越写越烂的现实折磨过,至少值得 demo 一下,看搜出来的东西像不像它说的那么准。
整个生态终于承认 “把 context 越塞越长” 不是解决方案,记忆、检索、consolidation 才是。这事跟模型变大变贵无关 —— 是工程默认假设要换了。
原始出处 · 第一条评论拿
关注 @svtransit1 · 写给真在用 AI 的人
#AI #ClaudeCode #AIagent #开源 #AI工具
原始来源:https://github.com/rohitg00/agentmemory
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS