
function calling 这两年默认是 sync-blocking——模型 decode 一次 tool call,停下来等结果,再继续。Berkeley 这周一篇论文说:LLM 其实天生就能处理"symbolic future",不用等。
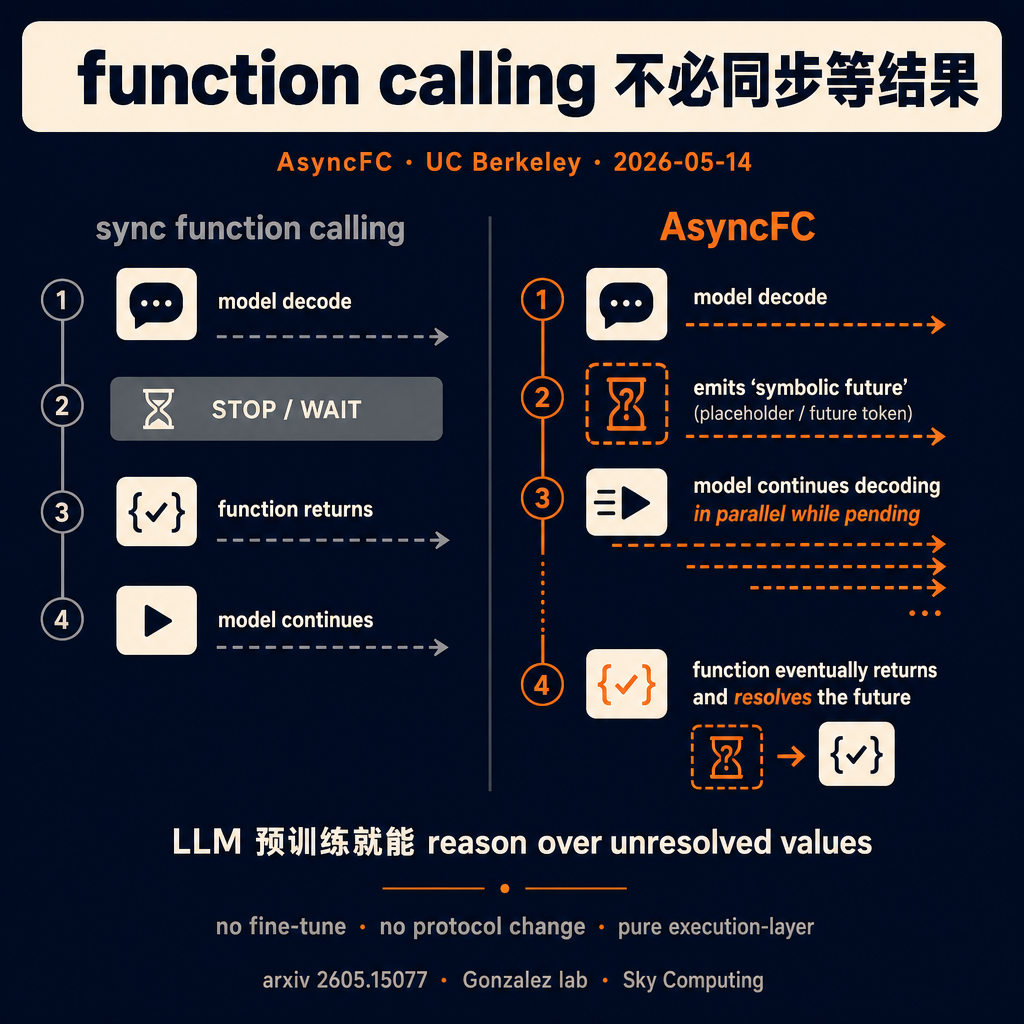
Joseph Gonzalez 组(Sky Computing Lab)这周挂的 AsyncFC。核心反直觉但漂亮:LLM decode 一段 tool call 之后,不需要拿到真实结果就能继续——塞一个 symbolic future 占位符进去,模型自己往下 reason,等 function 真返回时再 resolve。预训练就给了它”基于未知值推理”的能力,完全不用 fine-tune。
工程含义:decoding 和 execution 解耦并行;无依赖 tool call 也并行;不改模型权重、不改 function-calling 协议。端到端延迟显著降,accuracy 不掉。
真正有意思的不是延迟,是 framing 翻转:过去大家以为”LLM 必须看到真实结果才能 reason”,但事实上它处理 unresolved 值的能力是预训练默认的。agent runtime 工程一直在多做一道功——同步等结果——其实是给自己加戏。
LangGraph / AutoGen / OpenAI Agents SDK 加 future-aware 调度层,半年内的事。
转给那个还在写 sync function-calling 包装的朋友——LLM 比你以为的更聪明。
关注 @svtransit1 · 写给真在用 AI 的人
链接 · 👇 第一条评论
#AI #LLM #FunctionCalling #AgentRuntime
原始来源:https://arxiv.org/abs/2605.15077
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS