
在边缘设备(IoT、传感器节点、微控制器、低功耗 SoC)上跑 transformer,这两年是个公开痛点——单个设备的内存、算力、电量都撑不住完整模型。这周一组研究者(TU Darmstadt 的 Sebastian Trimpe + Marco Zimmerling)挂了 CATS,提出一个反直觉的方案:**别再压缩模型,把推理拆开,16 个超低功耗设备一起跑**。
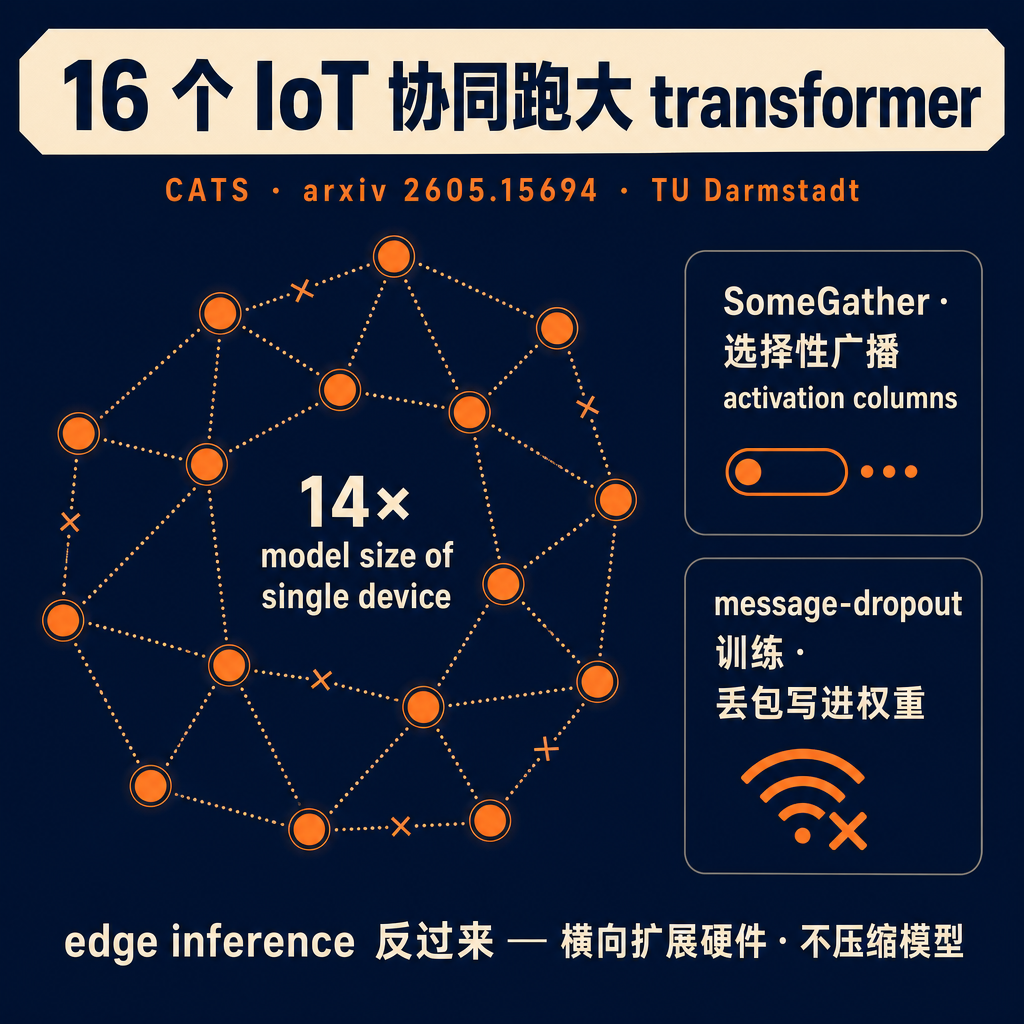
CATS 的核心机制有两个工程上很硬的设计:
第一,SomeGather——一个新的”剪枝过的通信原语”。在 transformer 的每一层,中间激活值(activation columns)本来需要在设备间全广播。SomeGather 只选择性广播那些”对下游计算有显著贡献的列”,其他列被丢掉。这能在不掉精度的前提下把通信带宽砍掉。在低功耗无线设备上,通信带宽就是电量——少传一份激活就多撑一阵子。
第二,message-dropout training——在训练阶段就模拟消息丢失。无线通信不可靠,数据包丢失是常态,但传统 transformer 训练假设所有 token / activation 都完整到位。CATS 在训练过程随机丢消息,让模型学会”信息部分缺失”也能产出正确预测。这等于把 “信道质量” 写进了模型权重里。
具体规模:up to 16 个超低功耗设备协同,跑的 transformer 模型尺寸是单设备最大可跑模型的 14 倍。等于:你原本能在一颗 IoT 上跑 7M 参数模型,现在 16 个 IoT 一起,能跑 100M 参数。
为什么这事重要——过去一年大家做”端侧 transformer”的默认路是把模型压小(蒸馏 / 量化 / 剪枝),”压到能跑为止”。CATS 这条路是反过来:不压缩模型,横向扩展硬件。一个 IoT 集群成为一个虚拟”大设备”。
应用层面立刻能想到的场景:车队 sensor-fusion(每辆车一颗节点,协同跑感知模型)、工业巡检机器人群(多臂协作)、智能家居网络(每个智能音箱 + 灯 + 摄像头分担推理)、农业田间分布式监测、灾后无中心环境下应急网络。这些都是单 IoT 撑不住完整模型 + 多 IoT 已经存在 + 间歇/不可靠无线连接的典型场景。
更深的潜台词:如果 CATS 路线可行,边缘推理的硬件采购逻辑就会变。过去大家想”换更强的边缘 SoC”——花钱升级单设备。未来可能是”加几个便宜节点”——把现有低功耗设备组成 swarm。这对硬件厂商的销售模型是个挑战,对 fabless 设计 + 协议层(BLE / LoRa / Wi-SUN)是个机会。
代码暂时没放(arxiv preprint)。但 Trimpe 实验室在控制系统 + 嵌入式领域里很活跃,几个月内出 follow-up 是正常节奏。
还有一个工程含义值得放到桌面上看——CATS 真正的赌注是”通信不可靠”这个前提。BLE / LoRa / Mesh / 工业总线环境下,数据包丢 5-15% 是常态。传统的”先训完美模型,再部署到带 retry 的稳定信道”思路在这种场景下崩——retry 机制让延迟爆炸。CATS 把丢包从”协议层的问题”提升到”模型权重的训练目标”,等于把硬件级别的真实世界写进 ML pipeline。这种”channel-aware ML”会成为边缘 AI 必修课。
转给那个还在为”端侧跑不了模型”硬塞蒸馏的朋友——也许换个 framing,加个节点就行。
关注 @svtransit1 · 写给真在用 AI 的人
链接 · 👇 第一条评论
#AI #EdgeAI #IoT #DistributedInference #Transformer
原始来源:https://arxiv.org/abs/2605.15694
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS