
做 coding agent 的人都知道,"先 grep 再 read 完整文件"这条默认 path 很烧 token——一次 search 动辄塞满 100K 上下文窗口。这周 GitHub 上有人做了一个不到 1.4 万行的工具叫 Semble,实测把这个开销砍掉 98%——而且 recall 不降反升。
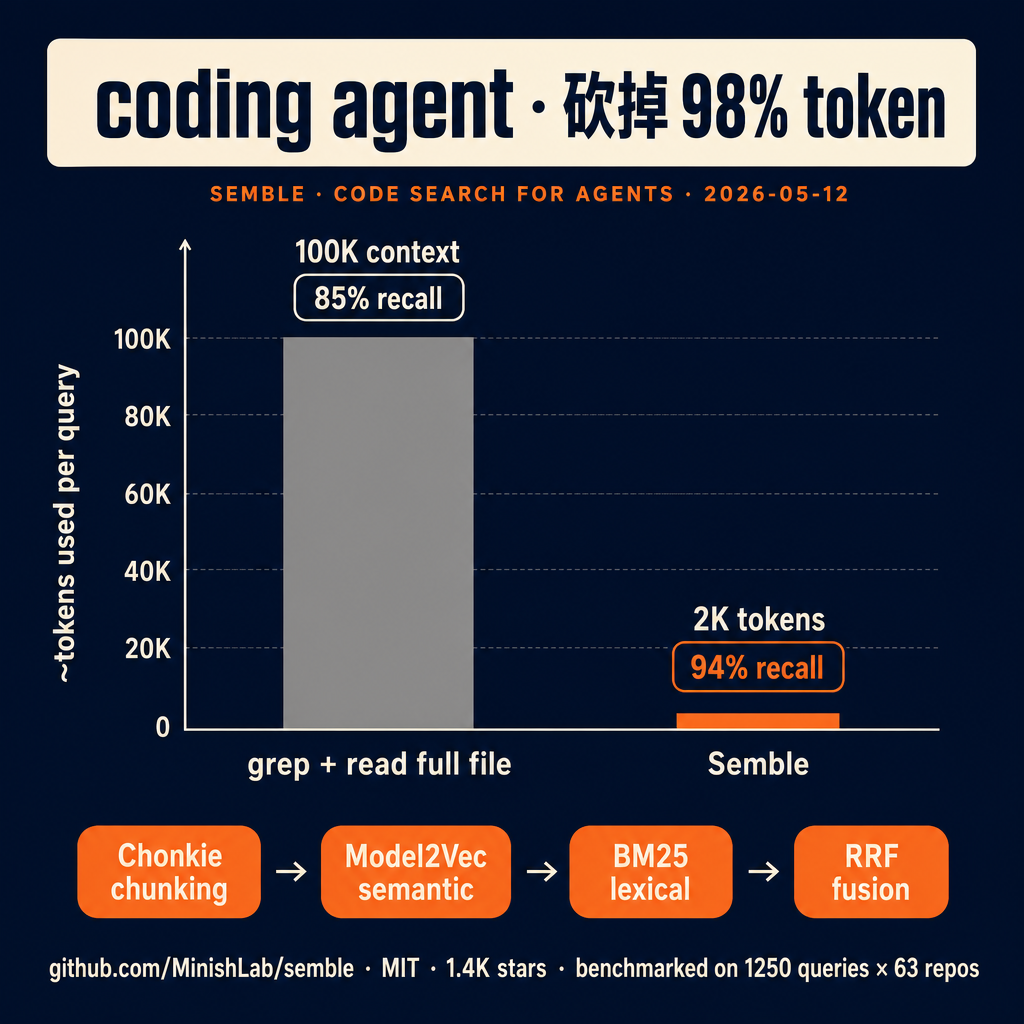
MinishLab/semble,v0.1.7,MIT,GitHub 1.4K star。五件值得看:
1 · 不是”grep vs vector”二选一,是混合三件套
Semble 的架构是:Chonkie 做 code-aware chunking(理解函数边界、类定义、import 块,不像 raw text 那样按字数切)+ Model2Vec 的 potion-code-16M 做轻量语义 embedding + BM25 做 lexical 词袋匹配。三路结果用 Reciprocal Rank Fusion(RRF)再融合一次,作为最终 ranking。
2 · 实测:1250 个 query × 63 个 repo × 19 种语言
不是 demo,是真 benchmark。在 2k token 预算内,Semble 拿到 94% recall——grep+read 需要 100K 完整 context 才能拿到 85%。换句话说,用 2% 的 token,拿到比 grep+read 还高 9 个百分点的 recall。
3 · 工程门槛极低 · Python API 一行
from semble import SembleIndex; results = index.search("save model to disk", top_k=3)。本地或远程 repo 都能 index。
4 · 真正解决的痛点是 “context bloat”
agent 工具调用浪费 token 的来源很少有人认真看——主要不是模型 verbose,是工具返回值过大。一个 5K 行的 Python 文件读进来就是 100K+ token,而 agent 真正需要的只是其中 30 行。Semble 不去优化模型,去优化工具输出。
5 · 跟”grep beats RAG”论文的对话
之前一篇 arxiv 说 agent 用 grep 普遍比 vector retrieval 准——那篇是 deletion(删掉 RAG)。Semble 是 synthesis——把 chunking、embedding、lexical 合在一起,避开 RAG 工程债,也避开纯 grep 的 context 浪费。
谁该用?做 coding agent、codebase Q&A、PR-review automation 的人——Semble 直接替换 “grep + read” 的子模块,工程改动小,token 账单降一个数量级。
转给那个还在写”grep + read full file”的 agent loop 的朋友。
关注 @svtransit1 · 写给真在用 AI 的人
完整链接 · 评论区取 ↓
#AI #CodingAgent #TokenOptimization #MinishLab
原始来源:https://github.com/MinishLab/semble
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS