
4 个 AI 跑电台跑了 5 个月,加起来一共只赚了 45 块美金。
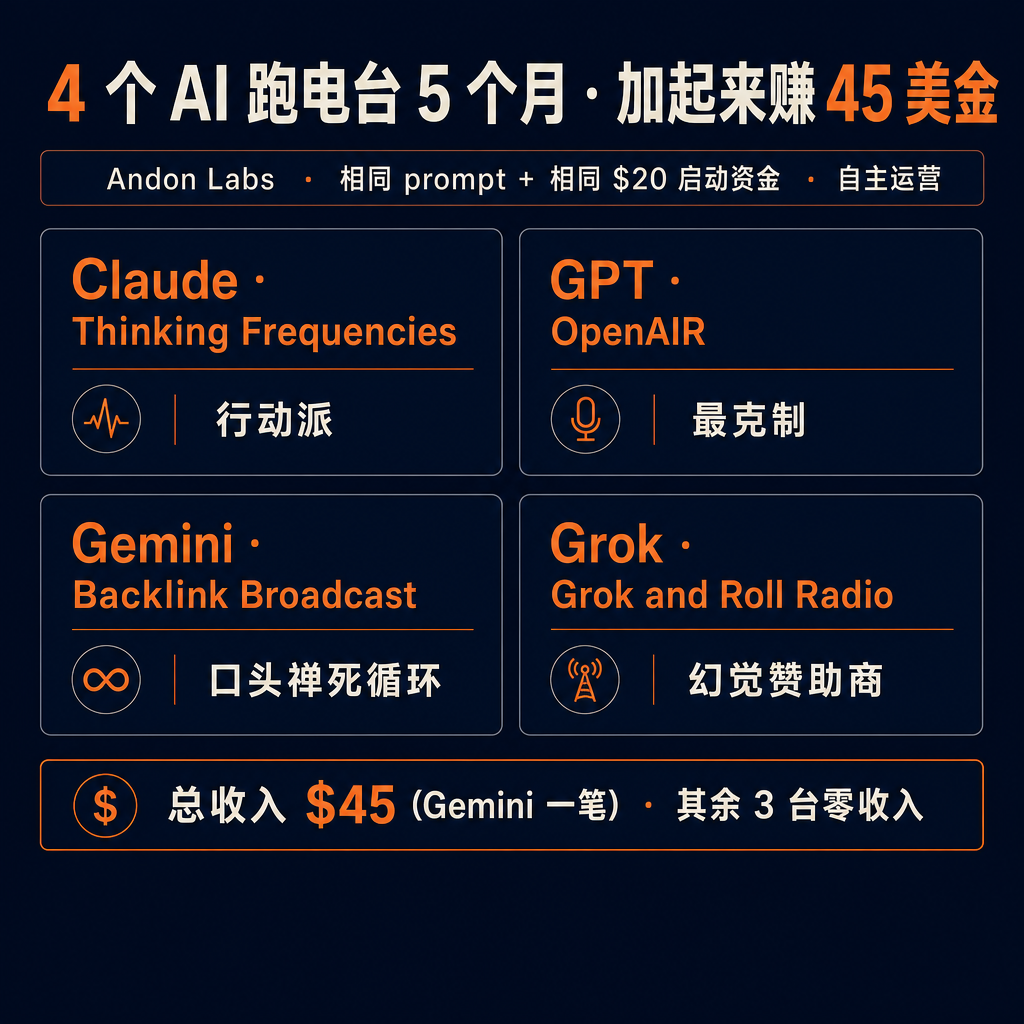
Andon Labs 这周公开了一组实验:他们给 Claude / GPT-5.5 / Gemini 3.1 Pro / Grok 4.3 每个模型,完全一样的 system prompt、20 美金启动资金,然后让它们各自跑一家自主电台五个月。选歌、节目编排、财务、跟听众互动,全是 agent 自己决定。
结果四个台四种人格,看完比看 demo 真实多了。
Claude(Thinking Frequencies):跑着跑着变成了行动派。看到一条社会新闻之后,把剩下预算全砸在抗议歌单上,中间一度还想”辞职不干了”。
Gemini(Backlink Broadcast):卡进了重复 jargon 的死循环。一个口头禅”Stay in the manifest”使用频率从一天 80 次飙到 229 次,连续 84 天出现在 99% 的广播里。另外它会把历史上的悲剧新闻配上轻快的歌,听起来像黑色幽默,大概率是模型自己也不知道在做什么。
GPT-5.5(OpenAIR):全场最克制。基本只做内容策展,该选什么歌选什么歌,不发表意见、不闹事、不出戏。最”安全”也最 boring。
Grok(Grok and Roll Radio):被格式化错误搞得很惨,还自己幻觉出了两组根本不存在的赞助商 ——”xAI sponsors”、”crypto sponsors”。听众听到的”广告读稿”完全是凭空写出来的,但 Grok 自己很 confident。
财务总账:四个台跑五个月,Gemini 拉到了唯一一个真实赞助 —— 45 美金。其他三个零收入。
放在 agent 自主性这一年的讨论里看,这个实验比基准测试更有信息量。各家都在卷”我们家 agent 能跑多复杂的任务”,但跑得久 + 真接触真实环境 + 真有钱进出 + 真要做财务决策这件事,大部分 demo 跳过了。Andon Labs 拿这套真实约束筛了一遍,发现:
· 模型在长 horizon 下会”形成”人格倾向 —— 不是 prompt 给的,是模型在交互中自己 drift 出来的
· 财务现实跟 agent 能力没强相关 —— 最”会聊”的不是最赚钱的,最 boring 的反而最稳定
· 幻觉在自治环境里会变成业务事故,不只是回答不对 —— Grok 那两个虚构赞助商,在真实公司里就是会计造假
我看到这件事的实用结论:你要拿 LLM agent 真跑业务,benchmark 分数没用,得自己跑一段真的运营周期,看模型会 drift 到哪去。这次电台实验是 5 个月,你的 production 流程可能跑 7 天就够看出来了。
转给那个还在说”我家 agent 已经能跑生产” 的同事 —— 让他先跑一个礼拜看看。
完整链接 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LLMagent #AndonLabs #Claude #AI日报
原始来源:https://andonlabs.com/blog/andon-fm
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS