
一个自托管的 8B 小模型,在 26 个 multi-step agentic 场景的 eval 里拿到 86.5% —— 没换模型,只在外面套了一层叫 Forge 的东西。
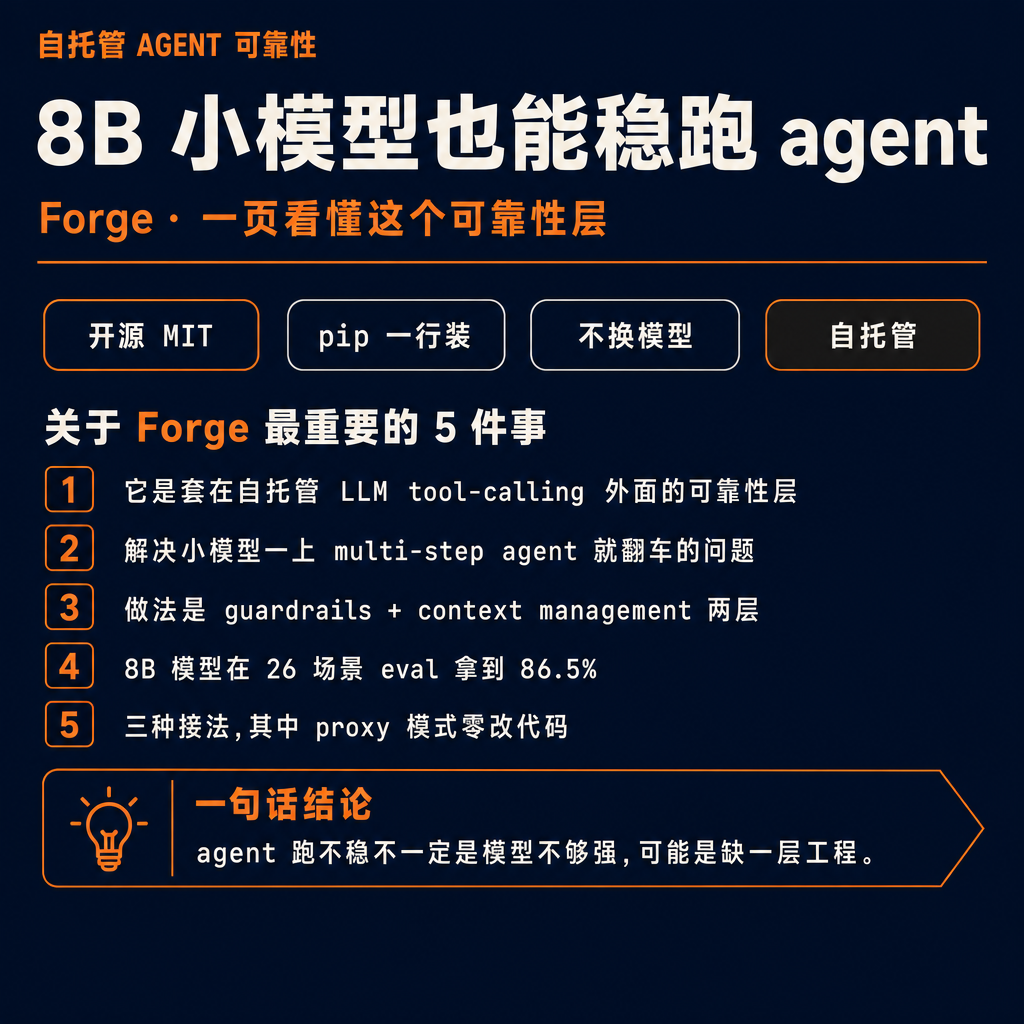
Forge 是个开源「可靠性层」,GitHub 九百多星,MIT 协议,一行 pip 装(forge-guardrails)。它专门解决自托管路线上最难受的一个问题:小模型单步还行,一上 multi-step agent 就开始翻车 —— tool call 格式吐坏、该走的步骤跳过、上下文塞爆。
它的做法是把「可靠性」拆成两层套上去。
第一层是 guardrails。模型吐出一个格式坏掉的 tool call,Forge 的 rescue parsing 去把它救回来,而不是整轮失败;模型没调对工具,retry nudges 推一把让它重试;多步流程里,step enforcement 强制该走的步骤不许跳。
第二层是 context management。VRAM-aware 的 token 预算 —— 它知道你显存多大、能塞多少;再配合 tiered compaction 分层压缩历史上下文,不让小模型那点 context window 被一轮轮对话塞爆。
效果就是开头那个数字。目前最强的自托管配置,是 Ministral-3 8B Instruct Q8 跑在 llama-server 上,在 Forge 自带的 26 场景 eval 里拿到 86.5%,最难的一档也有 76%。一个 8B 模型在 multi-step agentic 任务上跑到这水平,撑住它的是外面那层,不是参数量。
接进去有三种方式。直接在 Forge 上开发,用 WorkflowRunner,它把整个 agent loop 全包:系统提示、工具执行、上下文压缩、guardrails。已经有自己的编排循环,就把 Forge 的可靠性栈当中间件塞进去,循环还是你的,它只管校验和救援。最省事的是 Proxy server —— 一个 OpenAI 兼容代理,python -m forge.proxy,夹在 opencode / Continue / aider 这类客户端和本地模型之间,客户端以为自己在跟一个更聪明的模型说话。backend 支持 Ollama、llama-server、Llamafile,也支持 Anthropic。
Proxy 这个模式我觉得最值得留意 —— 因为它不要求你改任何代码。你现有的 opencode、aider 配置不动,只把模型地址从本地 server 换成 Forge 代理的地址,guardrails 就透明生效了。对「想试但不想重构」的人,门槛基本是零。
Forge 真正的信号,是它把「agent 可靠性」从模型能力里拆出来,变成一个独立的工程层。过去一年大家默认「agent 跑不稳 = 模型不够强」,Forge 证明同一个 8B 模型,加不加这层,差距大到能决定它能不能上生产。在自托管这条路上 —— 不管是为了省 API 钱,还是为了数据不出本地 —— 这层都值得单独认真做。
转给那个还在为自托管 agent 翻车头疼的朋友。
链接 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LocalLLM #AIagent #自托管 #开源
原始来源:https://github.com/antoinezambelli/forge
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS