
你的 Claude Code 账单,有一大半花在了「找路」上,而不是「干活」上。
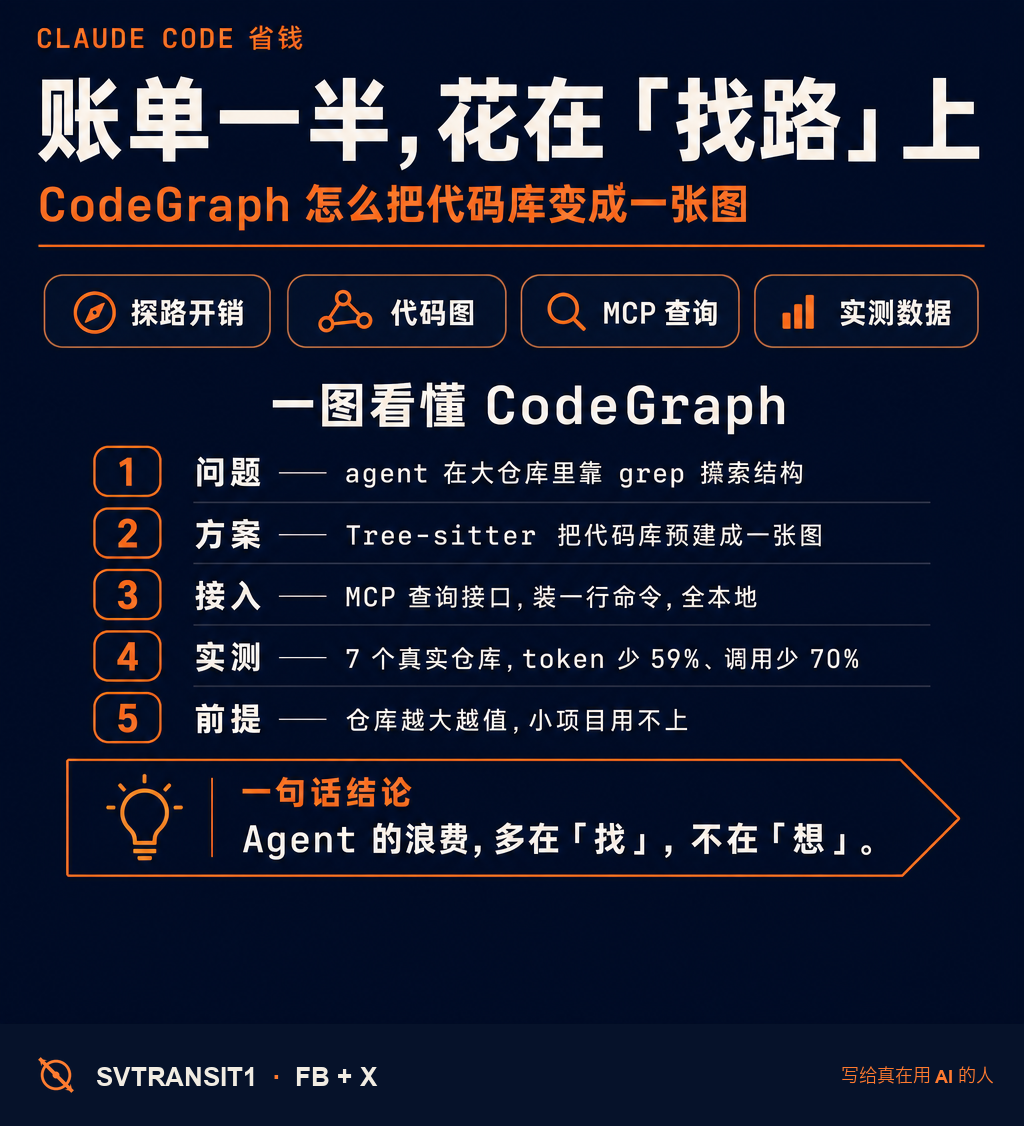
这不是个比喻。有人把 Claude Code 在 7 个真实开源仓库上跑同样的任务,挂一个叫 CodeGraph 的工具、和不挂,认真做了对比。结论挺扎心:不挂的时候,模型大量的 token 和工具调用,都耗在了摸索代码结构上——grep 一下、打开个文件、顺着调用链再翻一层、发现不对再翻回去。真正用来解决问题的那部分,反而是小头。
想想 Claude Code 在一个陌生的大仓库里是怎么干活的。它没有这个项目的全局地图。你让它改一个函数,它得先找到这个函数在哪、谁调用了它、它又调用了谁、改完会牵动哪些地方。每一步都是一次 tool call,每一次 grep、每一次读文件,都把一大段内容灌进 context。仓库越大,这种「探路」的开销越夸张——而这部分开销,和任务本身难不难,几乎没关系。
CodeGraph(开源,MIT 协议,GitHub 10.3k 星)的思路很直接:别让 agent 每次现场摸,提前把整个代码库画成一张图。它用 Tree-sitter 把源码解析成 AST,抽出里面的节点——函数、类、方法,以及它们之间的边——调用、import、继承、实现关系,全部存进一个本地的 SQLite 库。然后通过 MCP 暴露一组查询接口:搜符号、查谁调用了它、查它调用了谁、查一处改动的影响面。Claude Code 要理解一段代码时,直接查这张已经建好的图,不用一个文件一个文件地现翻。装一行命令,全程本地,代码不出你的机器;它还带一个文件监听器,你改代码的时候图会增量更新,不用手动重建。
7 个仓库的对比数据,平均下来:token 少用 59%,工具调用少 70%,整体成本便宜 35%,速度快 49%。挑几个具体的看:Django 上同一个任务,挂 CodeGraph 用掉 49.9 万 token、9 次工具调用;不挂,要 140 万 token、48 次调用。VS Code 那个仓库,工具调用从 23 次压到 7 次;Excalidraw 更夸张,83 次压到 12 次。数字背后是同一件事——agent 不用再自己探路了。
再往深一层看:工具调用砍掉 70%,省的不只是那几十次调用本身。Claude Code 是有 context 窗口的——agent 每 grep 一次、每读一个文件,那段输出不会用完就扔,它会一直留在对话里,陪着后面每一步。探路阶段塞进去的几十万 token,会持续抬高之后每一轮的成本。所以减少前期摸索,省的是一条复利曲线,不是一笔一次性开销。这也解释了为什么仓库越大、对话越长,CodeGraph 把差距拉得越开。
那具体哪类活儿受益最大?凡是要跨文件理解的——重构一个被到处调用的函数、评估一处改动的影响面、回答「这东西到底在哪些地方用到了」——这些任务,不挂图的 Claude Code 得靠一连串 grep 和文件跳转拼出全貌,正是 token 烧得最凶的地方。反过来,如果你只是让它在一个孤立的新文件里写点东西,跟代码库其余部分没多少牵连,CodeGraph 基本帮不上忙,你也不需要它帮。
也正因如此,有个前提得说清楚,免得期望错位:这套收益是跟着仓库规模走的。小项目,一两百个文件那种,本来 grep 一下就够快,建图反而成了额外开销,省不出多少。CodeGraph 真正发力的场景,是那种连你自己都记不清全貌的大代码库——仓库越大、调用关系越绕,它越值。
还有一点值得说:CodeGraph 走的是结构,不是向量。它给 Claude Code 的是「A 确实调用了 B」这种确定的事实,而向量检索给的是「这两段代码语义上看着像」的模糊匹配。对于「谁调用了这个函数」「改这里会动到哪」这类问题,你要的是确定答案,模糊相似度反而会把 agent 带偏。把代码库当成一张精确的图来查,而不是一堆可以「语义搜索」的文本块,这个区别在大仓库上会越来越重要。
老实说,这个方向是对的。Agent 的浪费,很多不在「想」,在「找」。我们习惯把 agent 跑得贵、跑得慢归到模型不够强上,但很多时候,它只是缺一张地图。先把结构喂给它,再让它干活——这件事就算不是 CodeGraph,迟早也会有人做,因为省下来的是实打实的账单。
如果你天天在大仓库里开 Claude Code,这一行命令,大概是今天能立刻看到回报的事里,最便宜的一个。
原文链接放在第一条评论 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #ClaudeCode #AI编程 #开源
原始来源:https://github.com/colbymchenry/codegraph
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS