
「一个模型标 30 tokens/秒,这到底算快还是算慢?」——这个问题问的人很多,但它其实问错了。
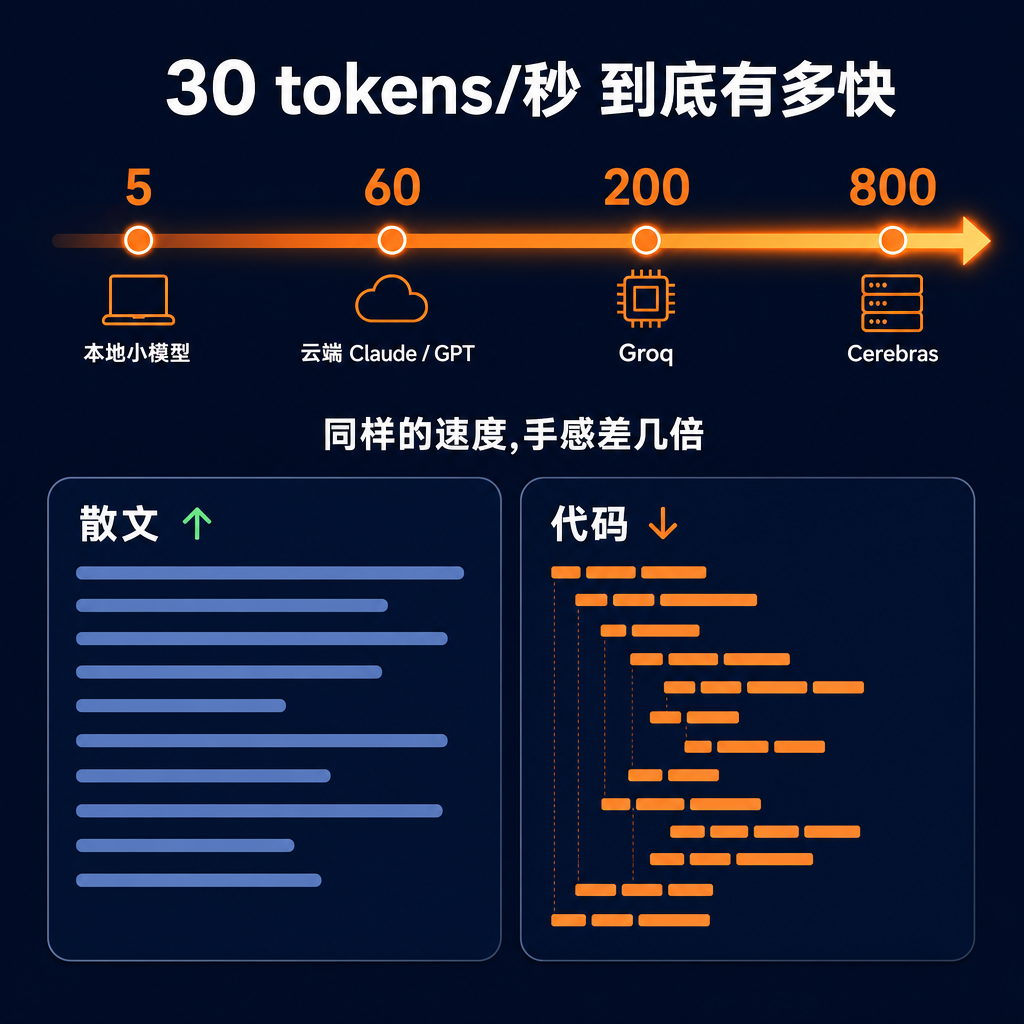
快不快,不取决于那个数字,取决于模型在生成什么。同样拨到 30 tokens/秒,让它写一段散文,字哗哗往外冒,你觉得飞快;让它写代码,卡顿感一下就出来了。大部分人盯着模型卡上的 tokens/秒 互相比,却忘了问一句:这个数,是在什么内容上测出来的。举个例子,两个模型都标着 60 tokens/秒,一个用散文测、一个用代码测,你真正上手时的快慢,根本不是一回事。
有人做了个很小的网页工具 tokenspeed,把这件事直接摆到你眼前。它有四档预设速度——5 tokens/秒差不多是树莓派级别的本地小模型,60 对应云端 Claude、GPT 给你的体感,200 是 Groq 那种专用推理芯片,800 就到了 Cerebras 这一档,默认停在 30,日常用的本地模型大多在这附近徘徊。更要紧的是它让你切四种内容来对照:纯文本、代码、带思考过程的推理、还有 agent 那种夹着工具调用的输出。
原因不玄。代码比散文「token 更密」。一句普通英文,平均一个词 1.3 个 token 上下,30 tokens/秒换算过来约等于每秒 23 个词,跟人正常说话差不多,所以读对话很跟手。可代码里全是括号、缩进、符号、短变量名,同样 30 个 token 摊到屏幕上,能看见的内容少得多,你盯着光标一个字一个字往外蹦,自然觉得慢。推理模型更极端——它哗一大段思考过程倒给你,你根本不会逐字读,那截 token 对你的「有效速度」几乎不算数。
所以下次再看到某个模型标「每秒多少 token」,值得多问一句:它测的是什么场景。同一个数,落到代码补全、长文生成、agent 跑工具链上,体感能差出好几倍——厂商当然挑最好看的那个报。比起 tokens/秒,更该盯的是每秒钟蹦出来多少你真正用得上的东西。
转给那个张口就拿 tokens/秒 比模型的朋友。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LLM #推理速度 #AI工具
原始来源:https://mikeveerman.github.io/tokenspeed/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS