
Agent 评测换了一种问法——「不是它能不能做完,是它能不能猜出你没说的那部分」。
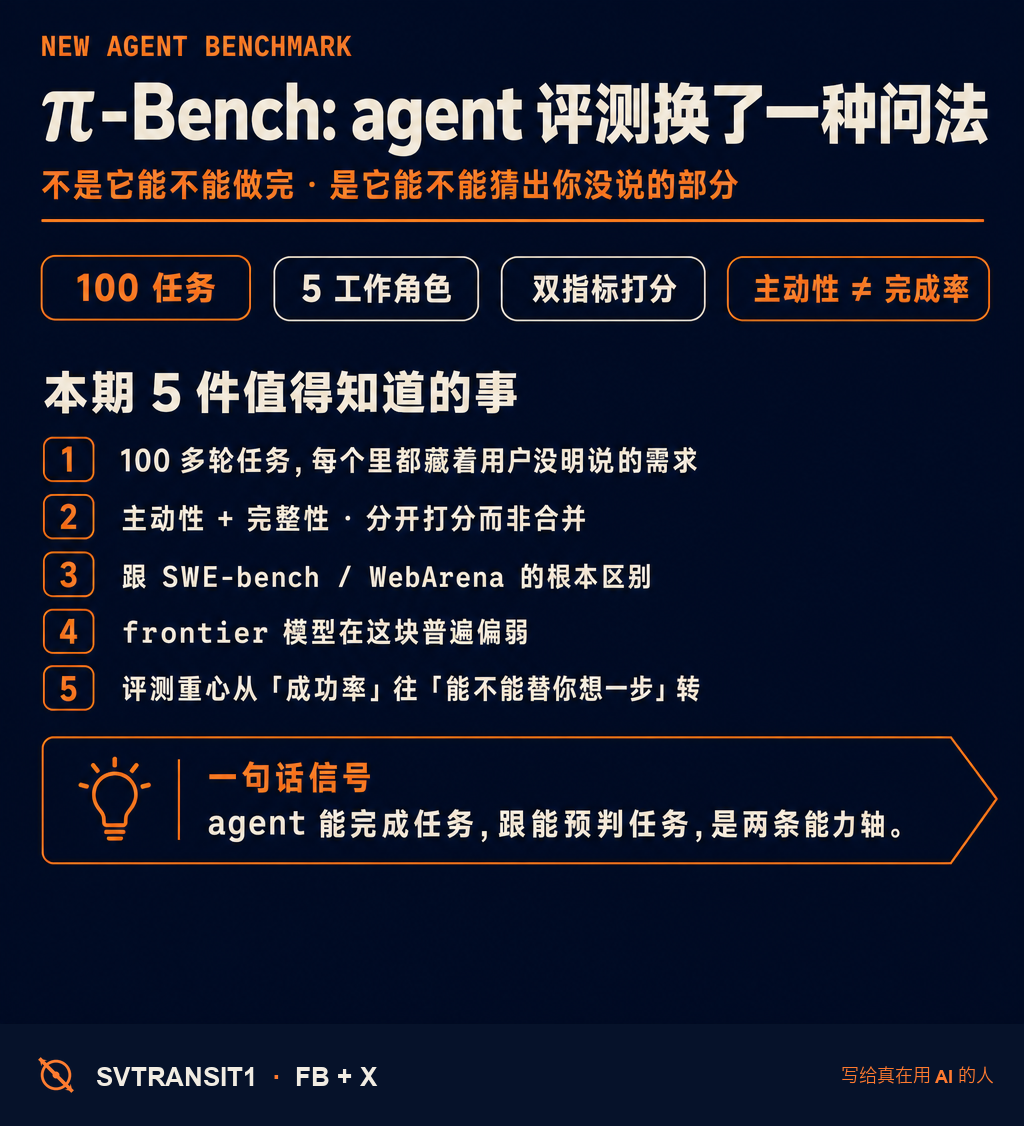
5 月发的一篇 arXiv 论文,把这种思路落成了一个新基准,叫 π-Bench(Proactive Benchmark)。下面 5 件值得知道的事:
- 100 个任务、5 种工作角色
每个任务都是多轮的;每个任务里,都藏了一些用户没明说出口的意图和依赖关系——这是这套评测最关键的设计点。
- 两件分开衡量的事
一边是「主动性」:agent 有没有发现用户没说出来的需求。另一边是「完整性」:它最后产出的工件本身够不够好。论文明确把这两件事拆开打分,而不是合成一个 success rate。
- 跟过去 agent benchmark 不一样在哪
过去测的是「给一个明确任务,看 agent 能不能跑通」——SWE-bench、WebArena、AgentBench 大多走的是这个套路。π-Bench 反过来——给的是一个模糊的工作请求,看 agent 能不能像一个有经验的助理那样,把没说的部分一起办了。
- 现有 frontier 模型结果不算好
论文原话:proactive assistance remains difficult。能跑完一个写清楚的任务、跟能预判一个没写清楚的任务,完全是两条能力轴。第一条这几年模型已经在快速爬;第二条几乎都还在起点附近。
- 下一阶段的意义
agent 评测的重心,可能要从「成功率」往「会不会替你想一步」这一头走。这跟 Anthropic 最近押的 Claude Skills、OpenAI 推的 Operator、Google 在做的 Agent Mode——这些「主动型」产品,其实是同一个研究方向的两面:产品落地的紧迫感和评测理论的紧迫感,刚刚对上。
具体一点理解「主动性」:假设你让一个 agent「帮我准备明天的会议」,被动型 agent 会问你「请给我会议主题、参会人、要准备什么材料」;主动型 agent 会从你的日历、邮件、上下文里自己拼出会议是什么、过往类似会议你准备过什么材料、这次还差什么——然后直接把材料先做出来一版。两种 agent 都能「完成任务」,但完成的是非常不同的任务。
论文 5 月 14 号挂出,5 月 19 号更新到当前版本,14 位作者,大多是中国学术机构。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AIagent #Claude #arXiv #评测
原始来源:https://arxiv.org/abs/2605.14678
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS