
「RLVR 训练里,大部分 gradient 都花在了格式 token 上」——5 月 20 号挂上 arXiv 的一篇 paper 这两天登上了 HuggingFace daily papers 榜首,做了一件听上去很朴素、但效果很直接的事。
paper 叫 DelTA(Discriminative Token Credit Assignment)。作者 Kaiyi Zhang、Yankai Lin 来自中国人民大学高瓴人工智能学院,Wei Wu 在 Ant International,代码挂在 github.com/RUCBM/DelTA。
故事是这样的:RLVR(Reinforcement Learning from Verifiable Rewards)是过去一年训练 reasoning 模型最常用的一套方法——给模型一个数学题或者代码题,跑出来对就 +1、错就 0,然后用这个 reward 反推 gradient,更新模型参数。GRPO、DAPO 这些都属于这个家族。
问题是,reward 是给整个 response 的,但 gradient 落在每一个 token 上。模型回答的时候,大部分 token 其实是格式相关的——「Let me think step by step」、「The answer is」、句号、换行——这些 token 跨着所有答案都长得差不多,不真正区分正确和错误的回答。当 gradient 被这些 token 摊薄,真正有判别力的那部分(具体推理步骤、关键计算)就更新得不够强。
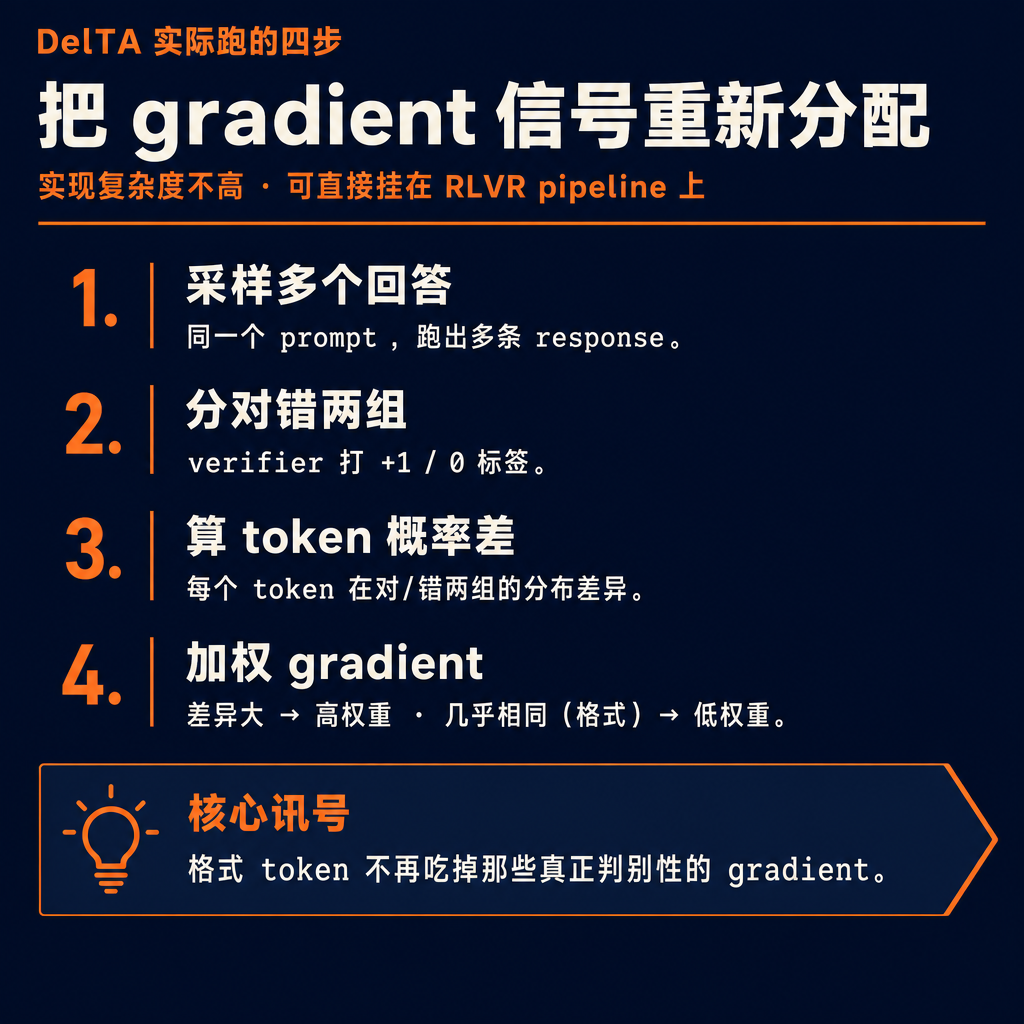
DelTA 做的事:在算 gradient 之前,先给每个 token 算一个 discriminative weight。判断标准是这个 token 在「对的回答」和「错的回答」之间有多大概率差异——分布拉得开的,权重高;分布几乎一样的(比如格式 token),权重低。然后把加权后的 gradient 喂回 policy update。
效果上,他们在两组 Qwen3-Base 上跑了一遍数学评测:Qwen3-8B-Base 平均拿到 +3.26 分提升,Qwen3-14B-Base 平均 +2.62 分提升,对照组是同 scale 的标准 RLVR baseline。绝对值不算夸张,但稳定地高于「换一个 reward 函数」或者「加点数据」能拿到的提升。
为什么这事值得看?过去一年 RLVR 这条线的优化主要是在 reward 信号本身(怎么生成更准确的 verifier、怎么处理 partial credit)。DelTA 把视角往下挪了一层——同样的 reward,把它在 token 之间分配得更精细。这是一个之前被忽略、但在 post-training 阶段大概率有杠杆的地方。
代码开在 github.com/RUCBM/DelTA。如果你在做 reasoning 模型的 post-training,这个方法的实现复杂度不高,值得在自己的 RLVR pipeline 里试一遍。
更大的意义在于:大模型训练这几年,大部分进展来自规模扩张——参数、数据、compute。DelTA 这类工作代表的是另一条线:不加任何资源,只是把已经在跑的 gradient 信号利用得更精细——挤出来的提升不大,但近乎免费。在 frontier 模型的边际成本越来越贵的当下,这条线的杠杆会越来越受关注。
转给那个在做 RLVR / post-training 的朋友——这个方法应该值得一试。
原始出处 · 第一条评论拿
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LLM #RLVR #Qwen #后训练
原始来源:https://arxiv.org/abs/2605.21467
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS