
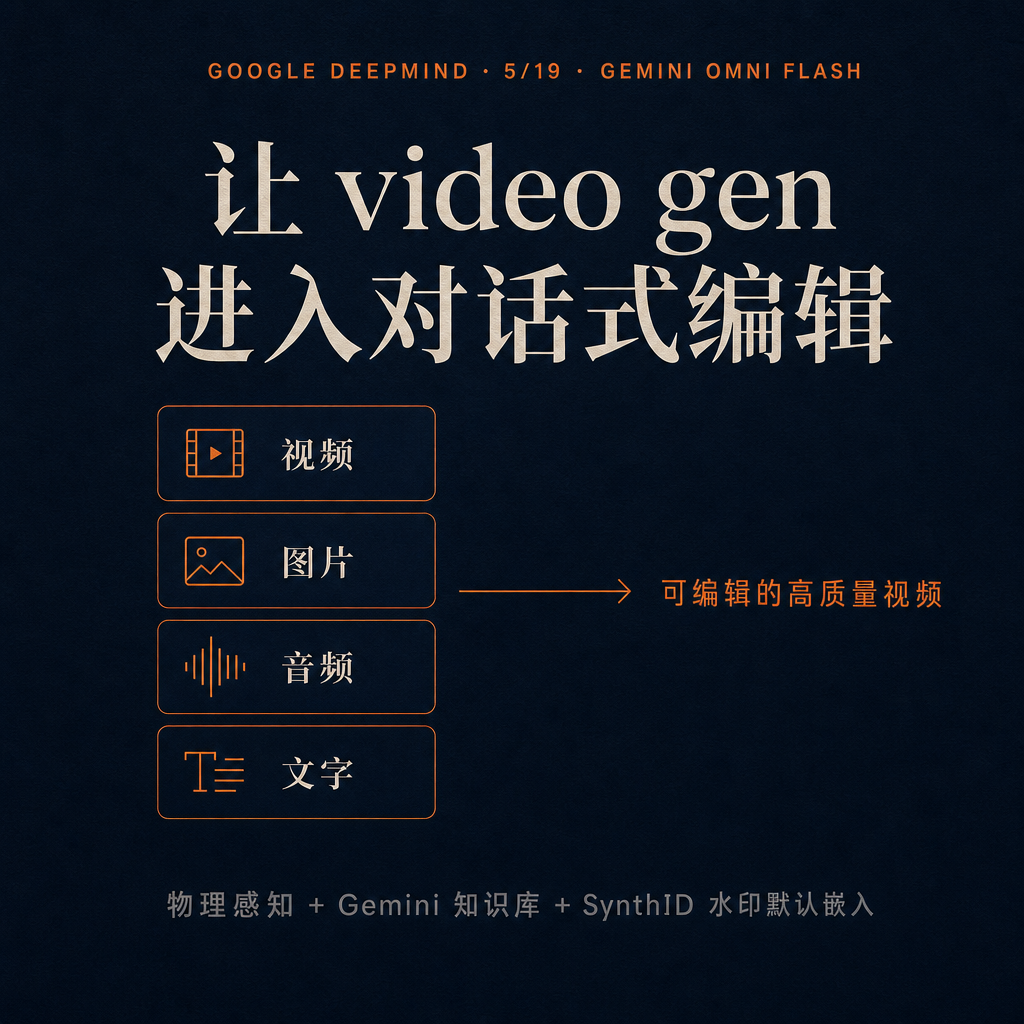
Google 上周(5/19)悄悄发了一份「Gemini Omni Flash」——是 Omni 这个新模型家族的首个版本,DeepMind CTO Koray Kavukcuoglu 亲自写的发布文。核心做的事:让 video gen 不只是「敲个 prompt 出一段视频」,而是可以对话式编辑。
挑几个具体的问答把这个东西讲清楚——
Q:它到底能输入什么?
A:视频、图片、音频、文字都行。你扔一段视频进去说「把背景换成夜景」,它出新的视频。扔一首歌进去说「按这个 BGM 节奏剪个 30 秒短片」,也直接给。
Q:跟过去的 video gen 模型最大的差别在哪?
A:对话式编辑 + 物理感知。过去你想改一帧细节,要重新跑一次。Omni 是「这段水流的方向反过来」「这个人物再加一个手势」这种自然语言迭代;再加上模型自己理解 gravity、kinetic energy、流体力学,生成的物理一致性比纯 pattern-matching 高一档。
Q:能调用 Gemini 的知识库吗?
A:可以。需要历史细节(古罗马服饰)、科学准确(行星轨道)、文化语境(节日传统)的时候,Omni 直接调用 Gemini 主线的知识,不需要你再 RAG 一遍。
Q:怎么用?
A:消费端在 Google AI Plus / Pro / Ultra 订阅里可用,YouTube Shorts 和 YouTube Create App 里有免费版本。API 这几周会陆续开给开发者和企业客户。
Q:跟昨天我们贴过的 NVlabs/LongLive 2.0(开源 video infra)是什么关系?
A:互补,不冲突。LongLive 是开源推理基础设施,解决「自己部署 video gen 怎么把速度推到 45 FPS」;Gemini Omni 是闭源 frontier 模型,解决「想要业内最强 video gen 质量怎么不用自己搭」。两条路同时跑得动,这周的视频生成赛道明显加速了。
放进更大的图里:今年视频生成已经从「能动起来」过渡到「能精确编辑 + 物理一致」这一层。SynthID 水印也被默认嵌进去——video gen 模型走出 demo、进入有合规要求的商用场景,这是必经的一步。
转给那个还在跟 Sora / Runway 周旋的朋友——Google 这个版本值得跑一遍对比测试。
发布文 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #VideoGen #Gemini #Google #DeepMind
原始来源:https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS